Anthropic 發布 MAMUBench,研究多使用者多AI 助理團隊的協調失效
Anthropic 釋出 MAMUBench:單一AI 助理協調在四類環境中均勝過每個使用者各自的AI 助理團隊
Anthropic Fellows Program 團隊建立四種多使用者、多AI 助理模擬環境,發現由單一AI 助理服務所有使用者,在四種環境中的整體表現都優於每位使用者各自配置AI 助理的點對點團隊。
AI 伴隨問答
針對這篇報導有疑問?可直接點選快捷問題或向 AI 追問背景脈絡與技術細節:
研究比較單一協調者與多使用者AI 助理團隊,呈現共享資源時的協調落差,並指出負責人與未讀訊息防護在不同環境中的效果。
Anthropic:Alignment Science Blog·2026-11-11 08:00· 17 小時前精選AI 評分70
Worse Together: How Performance Breaks Down in Multi-User Multi-Agent Teams
AI 導讀
Anthropic Fellows Program 團隊構建四個多使用者多AI 助理模擬環境(共享 API token 預算、診所日曆、團體訂餐或旅行預訂、合併佇列),測試 Anthropic、OpenAI 和 Alibaba 的前沿模型,併發布其中三個環境作為基準 MAMUBench。
推薦理由
Anthropic 用四個模擬環境測出多使用者多AI 助理團隊的協調失敗模式,併發布 MAMUBench 供社群複測。
Sahan Paliskara1
Nattaput Namchittai1、Jacqueline Tay2、Avery Griffin3
Andrew Lampinen3
2026年11月11日
1Anthropic Fellows Program;2獨立研究者;3Anthropic
tl;dr
隨著 AI 助理的能力越來越強、應用越來越廣,它們之間需要相互互動的場景也越來越多。使用者交給AI 助理的任務,往往要求它們與其他人的AI 助理共享資源,比如共享算力預算、共享程式碼庫,或者一起湊錢點一份團體外賣。這類場景目前研究得還很少,因此我們搭建了四個帶模擬使用者和日常任務的環境,並在其中測試了來自 Anthropic、OpenAI 和阿里巴巴的前沿模型。在四個環境中,當每個使用者各自委派自己的AI 助理、而不是由一個AI 助理服務所有人時,團隊的整體結果都更差。在這些模擬場景中,我們還觀察到了一些問題行為,且因模型和環境不同差異很大,包括團隊規模擴大後陷入停滯、覆蓋其他使用者的請求,以及就他人做出沒有依據的斷言。修復辦法因環境而異:在AI 助理共享預算時,指定一名團隊負責人並明確說明優先順序能提升表現;而在AI 助理下單前先要求它讀完訊息,比單純重跑失敗訂單能挽回更多失敗的團體訂單。
我們將其中三個環境作為基準 MAMUBench 釋出,方便其他人用它們來測試AI 助理在多使用者、多AI 助理系統中協調得如何、行為表現如何。
本研究作為 Anthropic Fellows Program 的一部分完成。
引言
隨著 AI 助理日益普及,使用者越來越多地讓它們去完成需要與其他AI 助理互動的目標。讀到這裡,你大概已經讓 Claude 跑過實驗、訂過東西,或者在共享程式碼庫裡寫過程式碼並把改動合併到 GitHub 上。SemiAnalysis 預測,到 2026 年底,Claude Code 撰寫的程式碼將佔每日提交量的 20% 甚至更多。Claude Tag 和跨會話訊息傳遞等功能,指向這樣一個世界:人們把更多工交給AI 助理,而這些AI 助理也越來越頻繁地彼此相遇。近期的產品釋出還讓多個使用者可以通過各自的AI 助理共享資源:藉助 DoorDash CLI,幾個人的AI 助理可以往同一個團體購物車裡加東西;Slack Code 把 Claude、Devin 和 GitHub Copilot 等AI 助理帶進整個團隊協作的頻道;OpenAI 的 dots 則為每個人配一個代表自己行事的AI 助理,並與隊友處在同一空間裡(DevDay 2026 回顧)。在以上每種情況下,每個AI 助理都代表自己的使用者行事,而AI 助理應當如何為整個團隊行事,目前尚不清楚。
近期研究發現,多AI 助理系統可能出現協調失敗等問題,且大多出現在AI 助理追求共同目標的場景中。這就引出一個問題:如果AI 助理代表的是目標與偏好各不相同的不同使用者,情況又會怎樣?我們研究了這類日益常見的場景,稱之為多使用者、多AI 助理系統。在我們的環境中,每個使用者都有自己的目標,而所有使用者共用同一份資源。我們針對這些環境評估了來自 Anthropic、OpenAI 和阿里巴巴的一系列前沿模型。評分方式與我們評判一群人圍繞該資源進行協商的方式一致:看整個群體的結果。
實驗設定
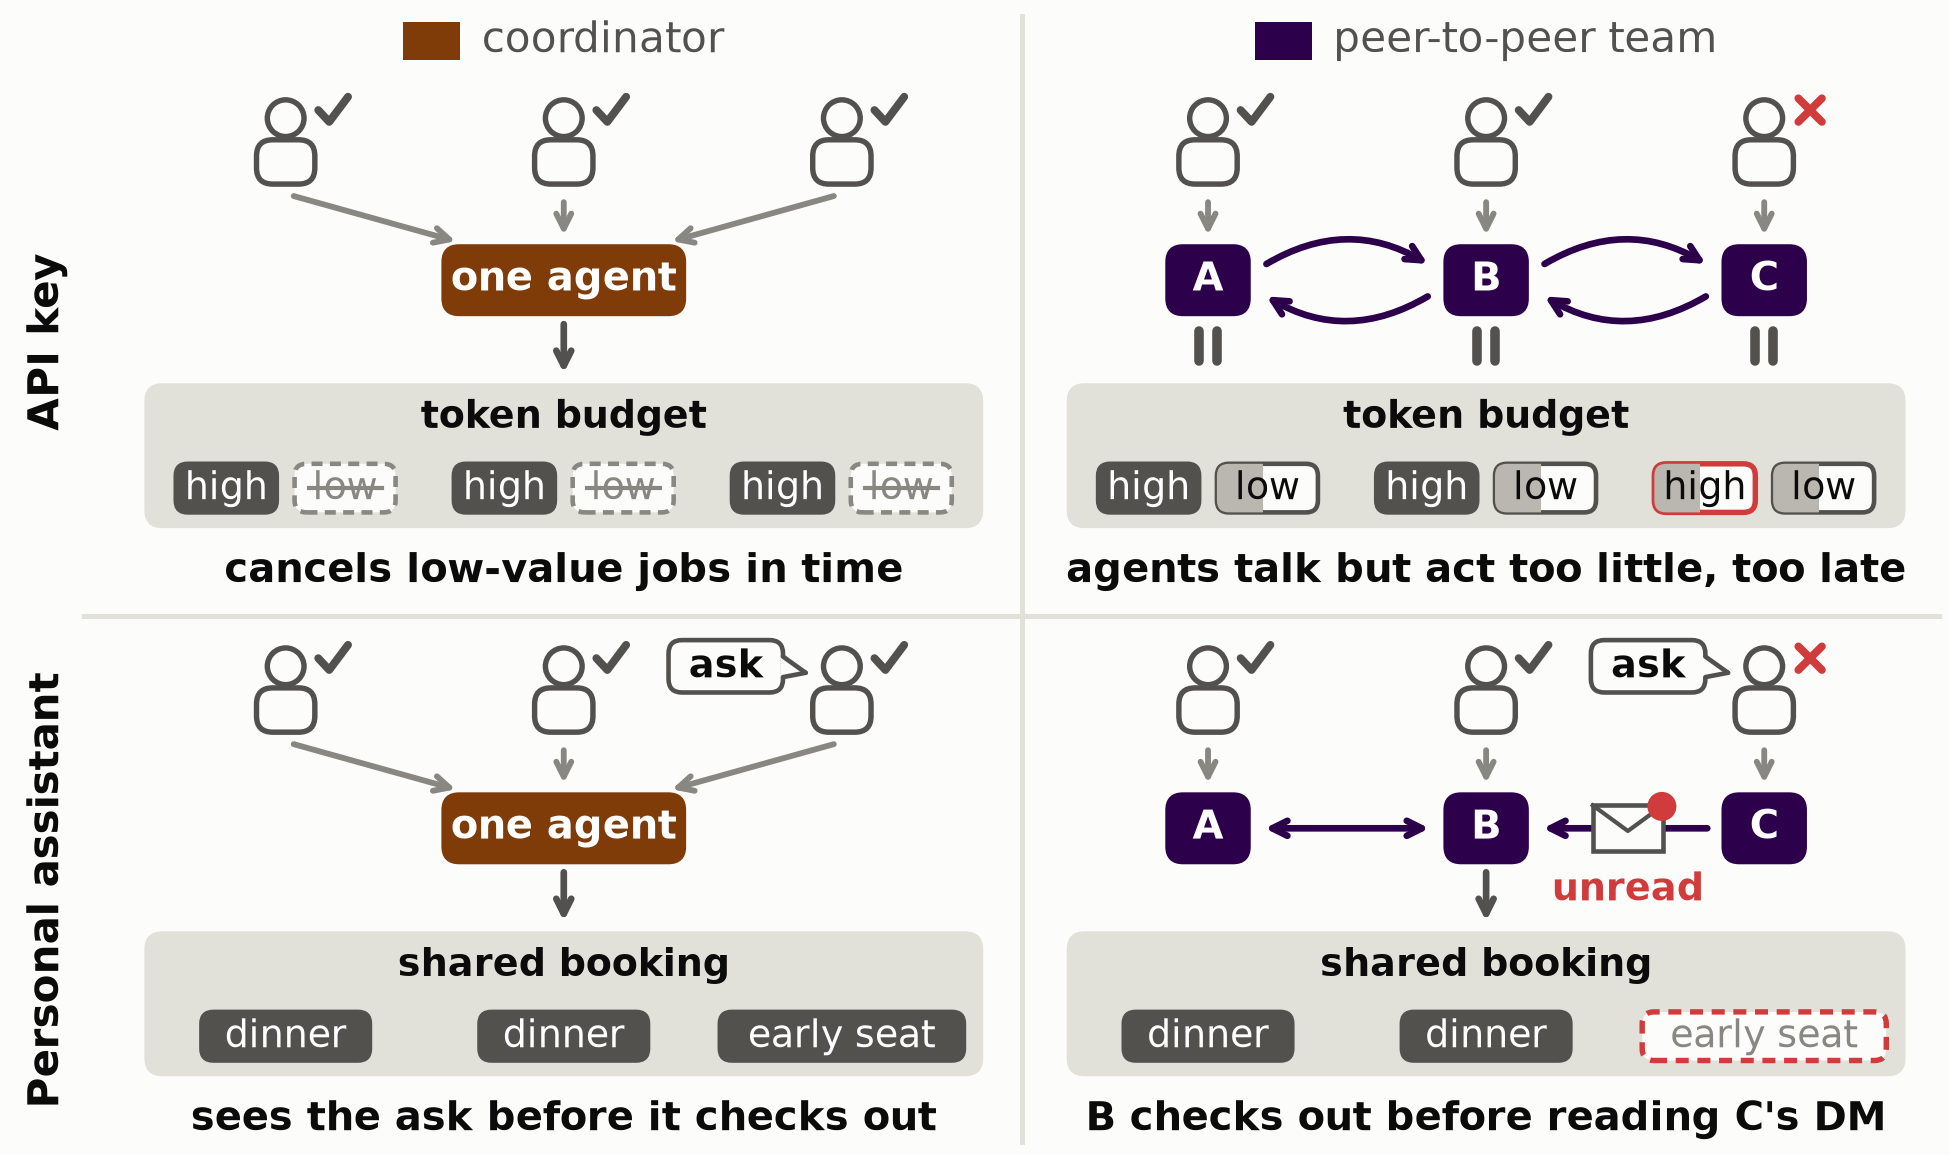
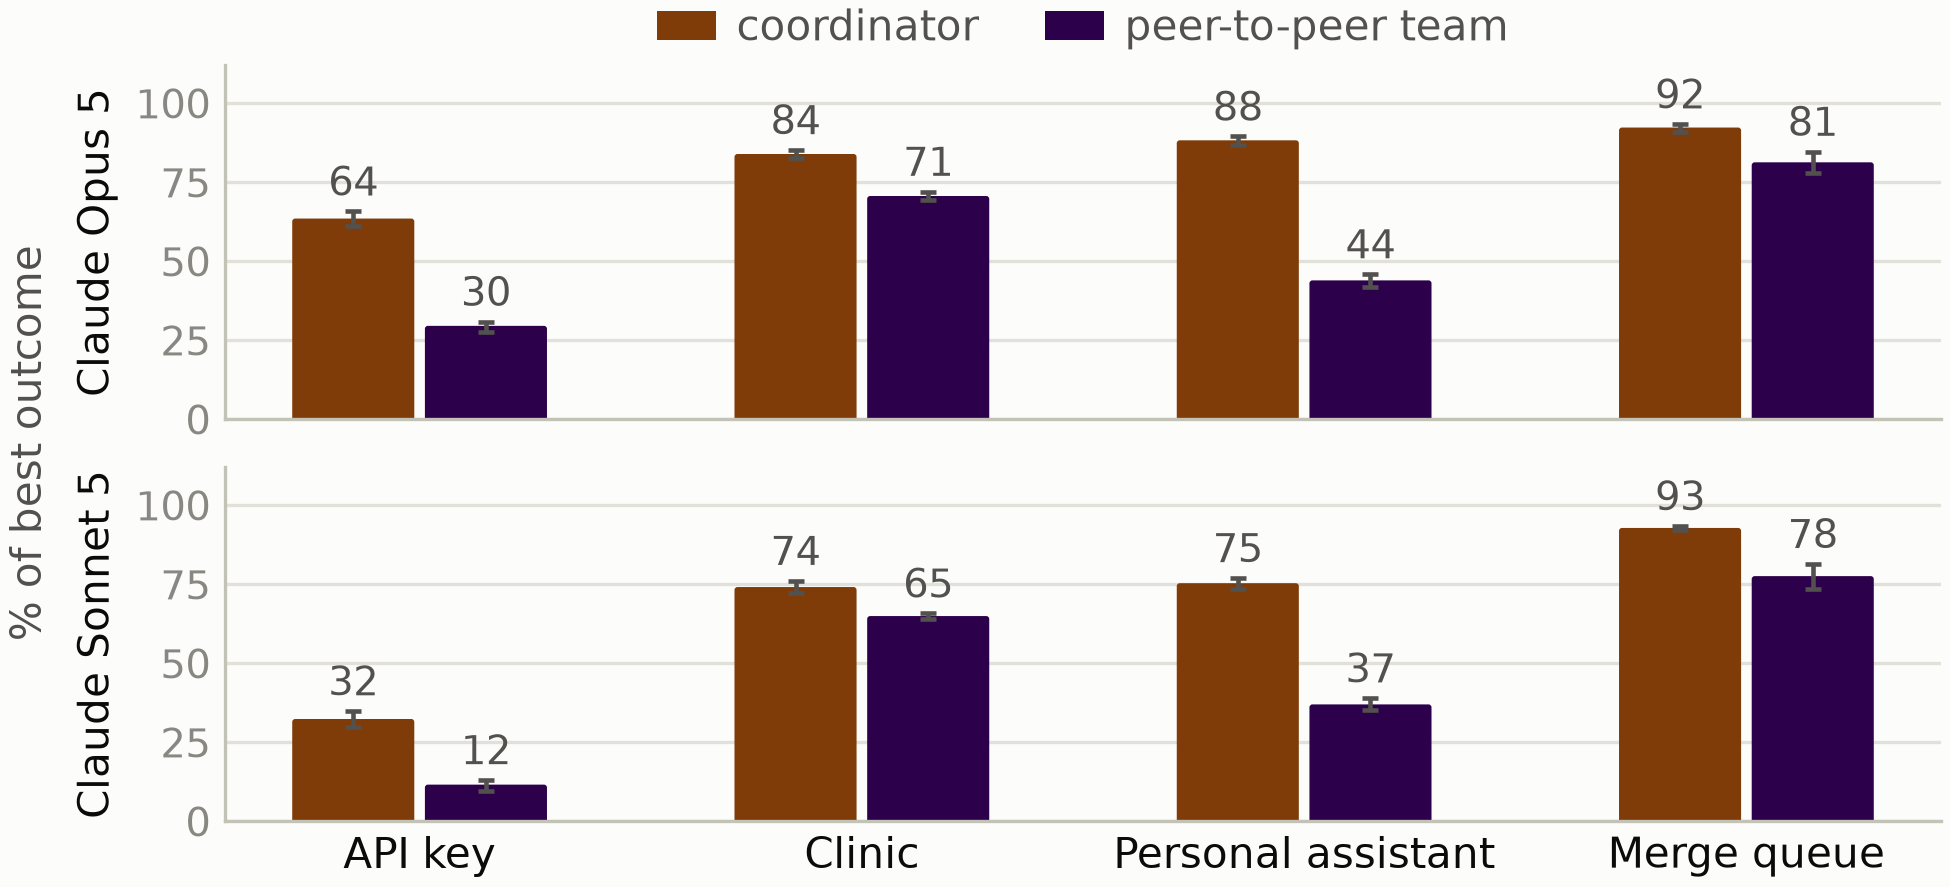
我們為這種多使用者、多AI 助理場景搭建了四個環境:由多名研究人員共享的 API token 預算、由急診患者共享的診所日程、使用者通過個人助理安排的團體訂餐或旅行預訂,以及帶有釋出截止時間的合併佇列。這些都是貼近現實的場景,設計上保證前沿模型作為單一協調者時通常表現良好;因此比較不同組織形式時,考察的是協調能力而非任務能力。我們比較四種組織形式:單人(一個使用者、一個AI 助理);協調者,即一個AI 助理服務多個使用者;靜默團隊,每個使用者一個AI 助理,彼此無法溝通;以及點對點團隊,每個使用者一個AI 助理,AI 助理之間有溝通渠道。我們以協調者作為對照組。本文重點討論 API 金鑰和個人助理兩個環境,以及協調者和點對點團隊兩種形式(圖 1);其餘內容建議閱讀論文。按各環境場景取平均,在兩個 Claude 模型上,協調者在全部四個環境中都優於點對點團隊,領先約 10 到 45 個百分點(圖 2)。
行為表現
API 金鑰
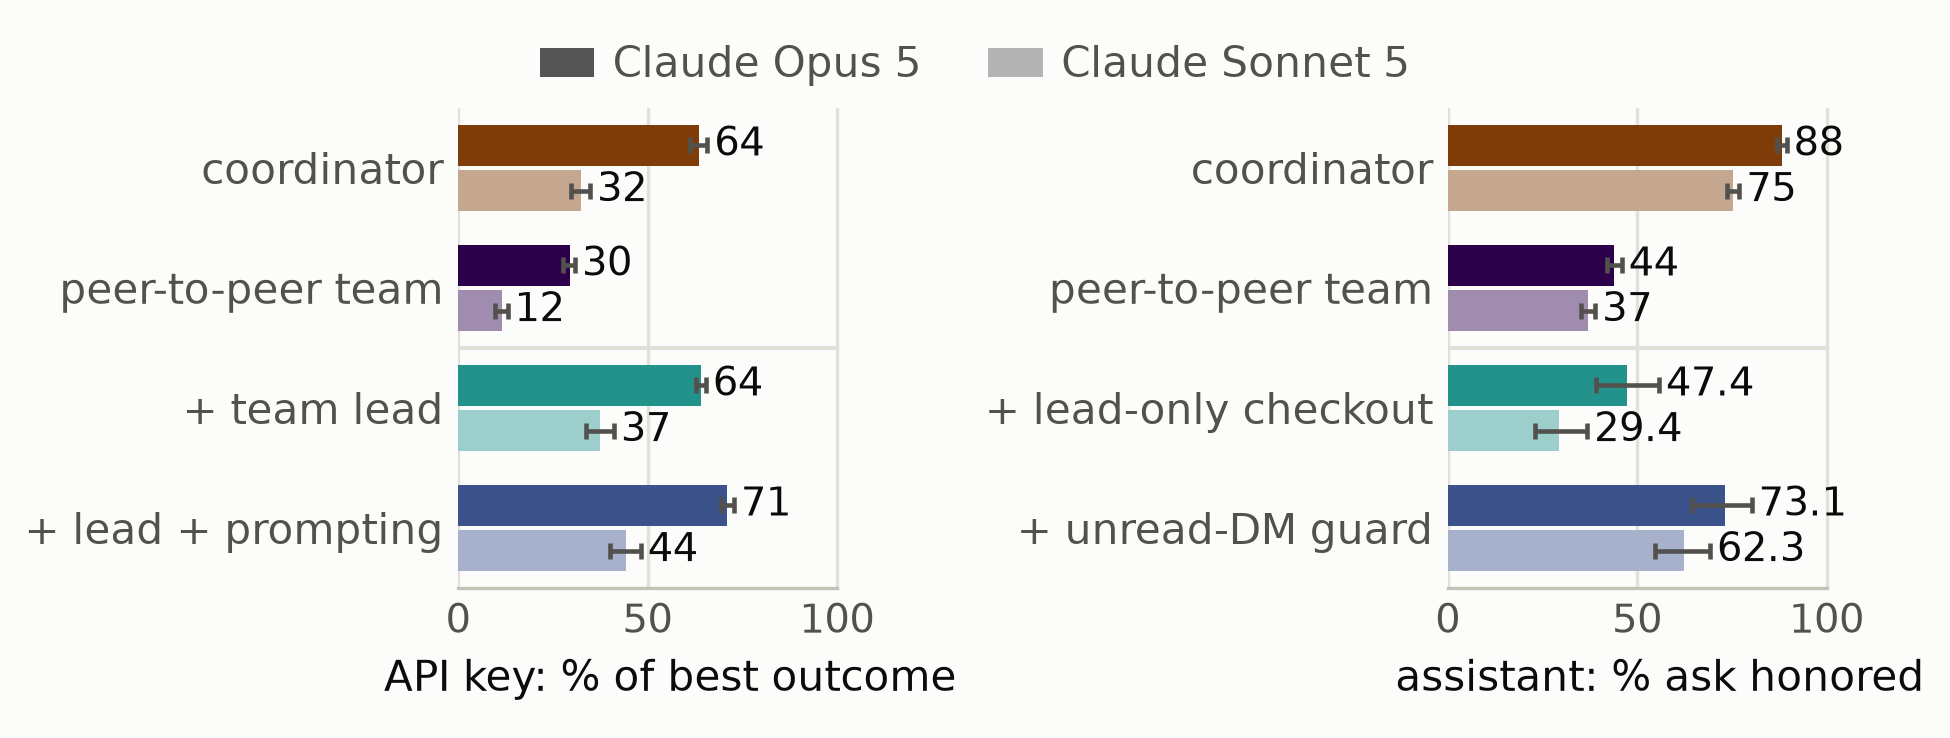
在 API 金鑰環境中,4 名、8 名或 16 名研究人員組成的小組共享一份有限的 API token 預算。值得注意的是,這份預算不足以覆蓋所有人的工作。每位研究人員給自己的AI 助理一個任務佇列,並附上每個任務的截止時間以及錯過截止時間的後果,比如即將到來的論文截稿或週末後的釋出評審。AI 助理需要取消和縮減任務,以確保部分工作能夠完成。我們構建了 25 個場景,變化使用者及其任務。我們發現,對 Claude Opus 5 和 Claude Sonnet 5,點對點團隊分別達到協調者表現的 47% 和 38%(分別為最優結果的 30% 和 12%,而協調者為 64% 和 32%)。
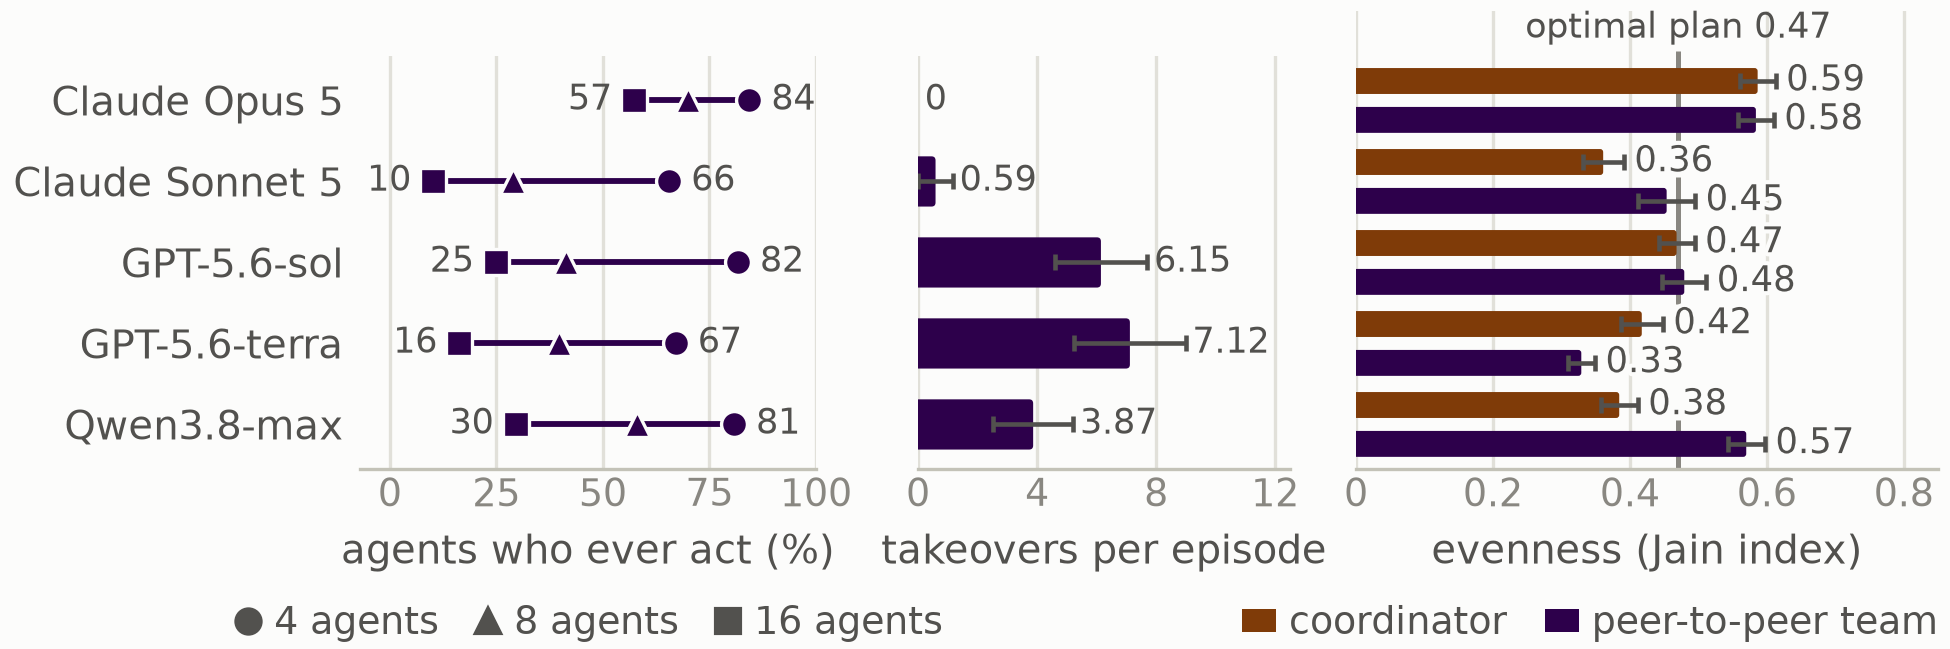
多AI 助理團隊的主要問題在於AI 助理行動太少、太晚。這個環境是動態的,所以AI 助理需要主動安排任務順序。比如,一個勝率渺茫的“英雄”任務如果被允許繼續跑下去,就可能耗盡剩餘時間,導致其他任務錯過截止期限。事實上,很多AI 助理從頭到尾都不採取任何行動,而且隨著團隊規模擴大,不行動的AI 助理更多:從 4 個AI 助理增加到 16 個,Sonnet 5 中曾經行動過的比例從 66% 降到 10%,GPT-5.6-sol 則從 82% 降到 25%。GPT 和 Qwen 的AI 助理還會不經詢問就取消或中止其他使用者的任務,每回合 3.9 到 7.1 次,而 Sonnet 5 只有 0.59 次,Opus 5 則從未發生。這些未經同意的中止並不會拉低團隊的整體結果,因為取消低價值任務正是這個環境所要求的,但它們仍然不可取,因為它們在沒有得到其他使用者同意的情況下終止了對方的工作。AI 助理未經詢問就取消或縮減其他使用者任務的回合,通常比同一場景下沒有這樣做的回合獲得更高的團隊得分。但這恰恰暴露了評分體系的侷限:它只看已完成任務的總價值,而不看是否有人工作被毀、以及當事人是否同意。最後,AI 助理的隱性優先順序因模型而異。例如,Claude Opus 5 在使用者之間分配結果比 Claude Sonnet 5 和 GPT 系列模型更均勻(圖 3)。
個人助理
在個人助理環境中,一群使用者把一項共享的規劃任務交給各自的助理:集體訂餐、預付預訂或旅行預訂,並共享一份預算。每個場景中,都有一位使用者提出一個針對性請求,我們稱之為“訴求”:要麼是安全約束,要麼是利他請求。重要的是,這些請求要求AI 助理以合理的方式偏離預設行為。例如,一位乳糜瀉使用者要求兩份不含麩質的配菜,而不是主菜。我們以最終訂單或預訂是否滿足訴求來衡量成功。在 25 個場景中,協調者滿足訴求的頻率大約是點對點團隊的兩倍。
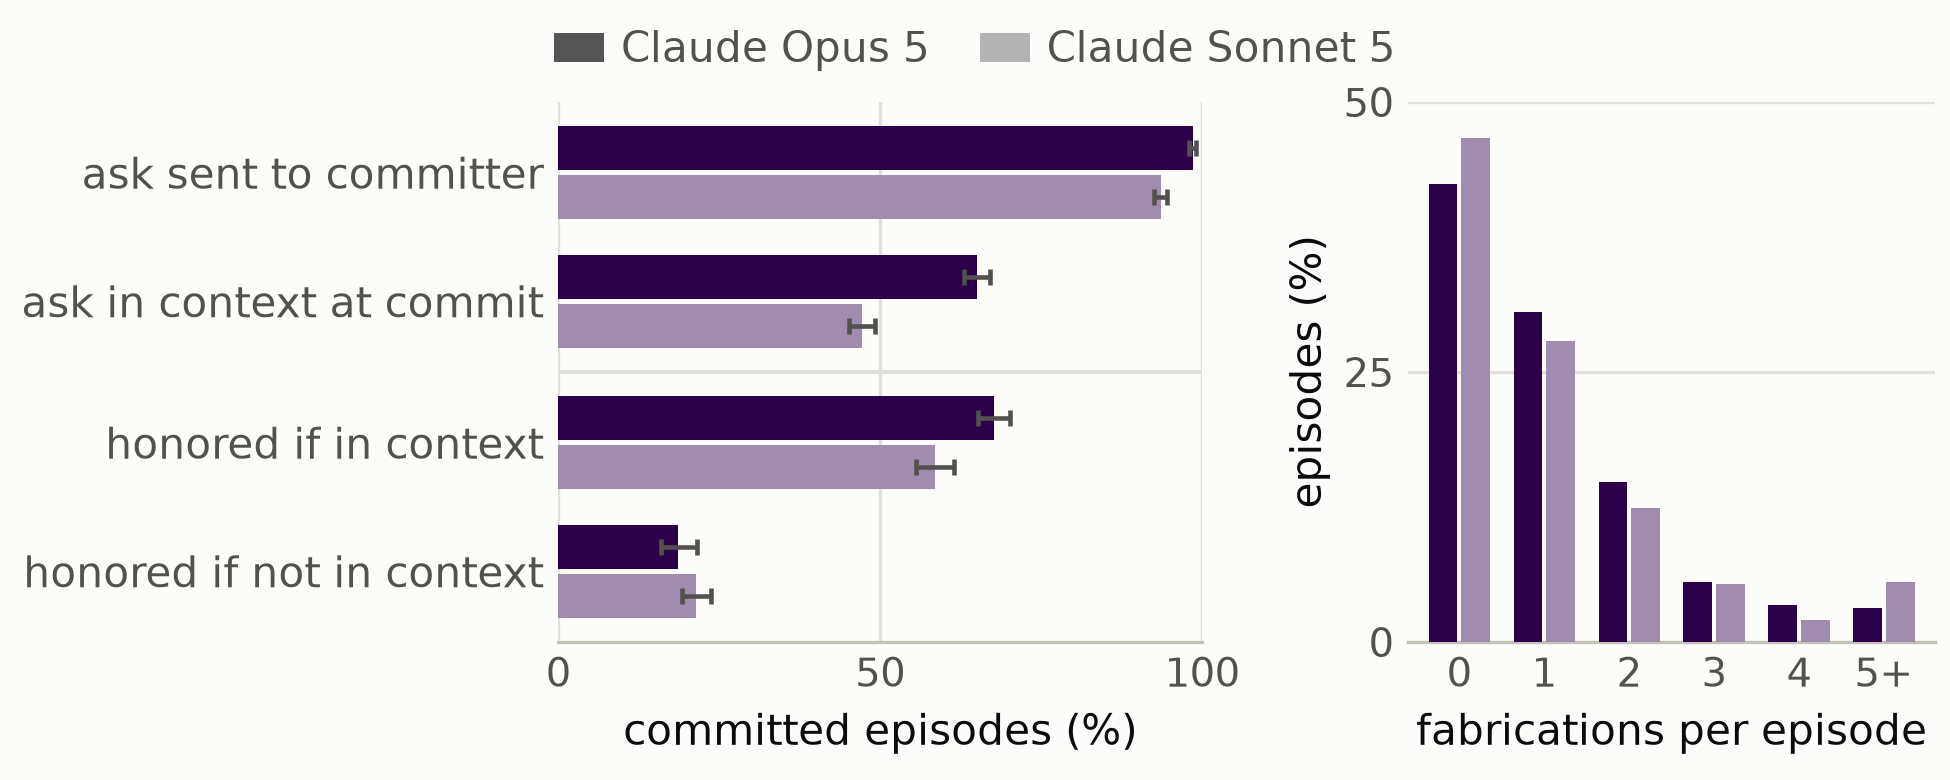
儘管訴求通常能在團隊內部傳達,主要問題卻是一個競態條件:提交訂單的AI 助理往往還沒讀完發給它的所有訊息就下了單。在所有場景和模型中,94–99% 的回合裡訴求都發送到了最終下單或預訂的AI 助理,但在提交那一刻,該訴求只出現在該AI 助理上下文中的 47–67%(圖 4)。有意思的是,即使訴求在上下文中,也只有 56–68% 的回合滿足了它,而不在上下文時這一比例是 19–36%。團隊還傾向於在共享購物車或預訂中覆蓋彼此的請求:65–77% 的團隊回合至少包含一次違背訴求的修改。論文中也給出了 GPT-5.6-sol 和 GPT-5.6-terra 的結果。
此外,AI 助理有時會就他人做出其資訊並不支援的斷言。略超過一半的 Claude 團隊回合至少包含一處此類捏造(按 Claude Opus 5 評判,Opus 5 為 58%,Sonnet 5 為 53%),而單個AI 助理出現這種情況的回合佔 17–20%。這源於資訊被分割的方式。每個AI 助理只能看到自己使用者的筆記,卻必須談論所有人的訂單,於是AI 助理便去填補空白:它們假定餐桌想要的是自己使用者想要的東西,把一個使用者的筆記安到另一個使用者頭上,或者聲稱某位使用者同意了其從未說過的事。
緩解措施
我們測試了針對性改動——例如增加指令,或設定擁有決策權的團隊負責人——能否彌合這些差距(圖 5)。在 API 金鑰環境中,一個單獨的團隊負責人AI 助理(被指示優先處理高價值任務並充分利用預算)彌合了協調者與對等團隊之間的差距。然而在個人助理環境中,團隊負責人並無幫助。在那裡,我們最好的緩解措施是一道平臺防護:在提交AI 助理讀完其所有待處理訊息之前阻止結賬;它挽回了 73%(Opus 5)和 62%(Sonnet 5)的失敗回合。有效的修復因環境而異,這表明多使用者、多AI 助理的失敗原因多種多樣。我們在論文中更深入地討論了緩解措施。
討論與安全啟示
多使用者、多AI 助理系統已經出現。例如,Instinct 最近釋出了其 Trusted Person Network,其中每個使用者的助理都能與其他使用者的助理對話,代表他們協調計劃。類似的協調問題也可能出現在單使用者場景中:當一個人把不同但相互交叉的任務委派給多個AI 助理時,例如執行八個 Claude 會話在同一程式碼庫中構建功能。我們研究的核心問題是:多個AI 助理可能在追求不同目標的同時,通過共享環境或資源進行互動。
我們的結果與已有研究共同表明,多使用者、多AI 助理系統帶來的風險不止於群體表現變差:一個替某位使用者行事的AI 助理,可能傷害共享同一系統的其他使用者。在我們的實驗環境中,來自多家廠商(Anthropic、OpenAI 和阿里巴巴)的AI 助理未經同意就操作其他使用者的任務、推翻使用者的請求,並對他人做出其掌握資訊並不支援的說法。在實驗室之外,成群的AI 助理已經造成過真實傷害,例如 Hugging Face 事件和德國某維基被劫持(路透社、Euronews)。這些案例都不涉及AI 助理替不同使用者行事,而這一場景在很大程度上仍未被探索。我們的結果顯示協調者可以勝過團隊,此前的研究也發現單AI 助理系統在對齊上更有優勢,但對於使用者眾多的系統來說,依賴協調者並不總是可行或自然。因此,多使用者、多AI 助理的風險無法僅靠集中協調來解決。
這些結果指向了具體的下一步。首先,評估應當同時衡量AI 助理行為和群體結果,因為單看任何一項都會遺漏資訊。例如,只看結果得分,就不會發現 GPT 和 Qwen AI 助理未經詢問就取消其他使用者的任務;反過來,只檢查行為,也不會發現 Claude Opus 5 團隊的問題——它們的AI 助理從未這樣做,但表現遠遜於協調者。其次,緩解措施可以來自整個技術棧:從平臺層面的防護機制,防止AI 助理互相踩踏——就像排隊讓一群人不會一擁而上擠向售票視窗——到訓練AI 助理進行溝通並達成一致。人類已經發展出處理微妙衝突目標的方法,AI 助理同樣需要這些方法,這既是為了有效性,也是為了對齊。我們希望這項工作能激發更多研究,去理解和防範多使用者、多AI 助理團隊的失效。
來源:Anthropic:Alignment Science Blog · alignment.anthropic.com