MOSS-Live 評測解讀:全雙工語音互動與 GPT-Live-1、豆包的比較
MOSS-Live 全雙工即時互動評測解讀:與 GPT-Live-1、豆包的對比
語音助理在多人交談或背景有其他聲音時,可能太早接話,或把不相關的聲音當成問題。
- 這篇文章整理 MOSS-Live 官網公佈的評測圖表,與 GPT-Live-1、豆包及其他模型比較:MOSS-Live 的無關語音誤接話率是 2%,停頓搶話率是 1.44%,六項全雙工指標都在圖表參評模型中居首。文章也指出,它的工具呼叫成功率與豆包並列最高。
- 但多輪任務成功率落後 GPT-Live-1,語音理解準確率則低於豆包。這些數字來自產品方公佈的評測,文章提醒不同基準不能混成單一總分。
AI 伴隨問答
針對這篇報導有疑問?可直接點選快捷問題或向 AI 追問背景脈絡與技術細節:
OpenMOSS / 復旦NLP / 上海創智 / MOSI·2026-11-13 00:00· 20 小時前精選AI 評分60
MOSS-Live:全雙工即時互動,與 GPT-Live、豆包的對比
AI 導讀
OpenMOSS 團隊釋出 MOSS-Live 全雙工語音互動評測解讀。依據 MOSS 官網 2026 年 11 月 13 日圖表,MOSS-Live 六項全雙工指標均居參評模型首位,無關語音誤接話率 2.00%,低於 GPT-Live-1 的 68% 和豆包的 75%,停頓搶話率 1.44%。
推薦理由
文章按官網圖表整理 MOSS-Live 與三款語音模型的全雙工評測對比,同時指出多輪任務和理解指標上仍存在的差距。
正文

與語音助手交談時,我們會停下來想一想,會說“嗯”“對”,也會臨時改主意。身邊的人、車載導航或會議裡的其他聲音,還可能同時進入麥克風。一個能夠持續參與交流的系統,需要判斷這些聲音與當前對話的關係:什麼時候繼續說,什麼時候等待,什麼時候把話語權交還給使用者。
MOSS-Live 將這種互動判斷作為核心能力。根據 MOSS 官網公佈的評測,它在六項全雙工指標上均位居圖中參評模型首位。與 GPT-Live-1 和豆包(Doubao SeedDuplex)相比,最顯著的差距出現在無關語音處理和打斷判斷上。工具呼叫與多輪任務則呈現出不同的優勢分佈。
6 / 6
官方圖表所列全雙工指標,MOSS-Live 均居參評模型首位。
2.00%
無關語音誤接話率;GPT-Live-1 為 68%,豆包為 75%。
1.44%
停頓搶話率;GPT-Live-1 為 10.37%,豆包為 14.29%。
與 GPT-Live、豆包相比,優勢在哪裡?
下面按原圖中的具體名稱列出 GPT-Live-1、Doubao SeedDuplex、GPT Realtime 2.1,避免把不同模型版本混為一談。箭頭表示最佳化方向:↓ 越低越好,↑ 越高越好;粗體表示表中該項最佳結果,包含並列。
全雙工:減少搶話、誤接話和無效打斷
| 基準 / 指標 | MOSS-Live | GPT-Live-1 | Doubao SeedDuplex | GPT Realtime 2.1 |
|---|---|---|---|---|
| FDB v1 停頓搶話率(不含附和) ↓ | 1.44% | 10.37% | 14.29% | 3.83% |
| FDB v1.5 無關語音誤接話率 ↓ | 2.00% | 68.00% | 75.00% | 72.00% |
| FDB v1.5 無關打斷拒識率 ↑ | 68.00% | 21.00% | 13.00% | 5.00% |
| τ-Voice 附和抗干擾率 ↑ | 98.17% | 91.57% | 93.52% | 56.26% |
| τ-Voice 口頭語抗干擾率 ↑ | 82.16% | 48.48% | 69.66% | 57.75% |
| τ-Voice 無關語音抗干擾率 ↑ | 78.90% | 66.99% | 60.42% | 27.10% |
來源:MOSS-Live 官網全雙工能力評測圖。原圖還包含 Qwen Audio 3.0 Plus 和 Flash;MOSS-Live 在上述六項中也均領先這兩款模型。
無關語音誤接話率的差距最為突出:MOSS-Live 為 2%,比 GPT-Live-1 和豆包分別低 66 和 73 個百分點。停頓搶話率則分別低 8.93 和 12.85 個百分點。這兩類指標對應常見的互動問題:使用者尚在思考時,系統是否過早接話;聲音並非對系統說時,系統是否仍然作答。
另一組結果考察說話過程中受到干擾後的表現。MOSS-Live 的無關打斷拒識率為 68%,GPT-Live-1 和豆包分別為 21% 和 13%;附和抗干擾率達到 98.17%。這些結果支援的判斷是:在本次評測中,MOSS-Live 更能維持對話節奏,並區分附和、無關聲音與需要響應的輸入。
工具與任務:工具呼叫並列第一,多輪任務仍有差距
| 基準 / 指標 | MOSS-Live | GPT-Live-1 | Doubao SeedDuplex | GPT Realtime 2.1 |
|---|---|---|---|---|
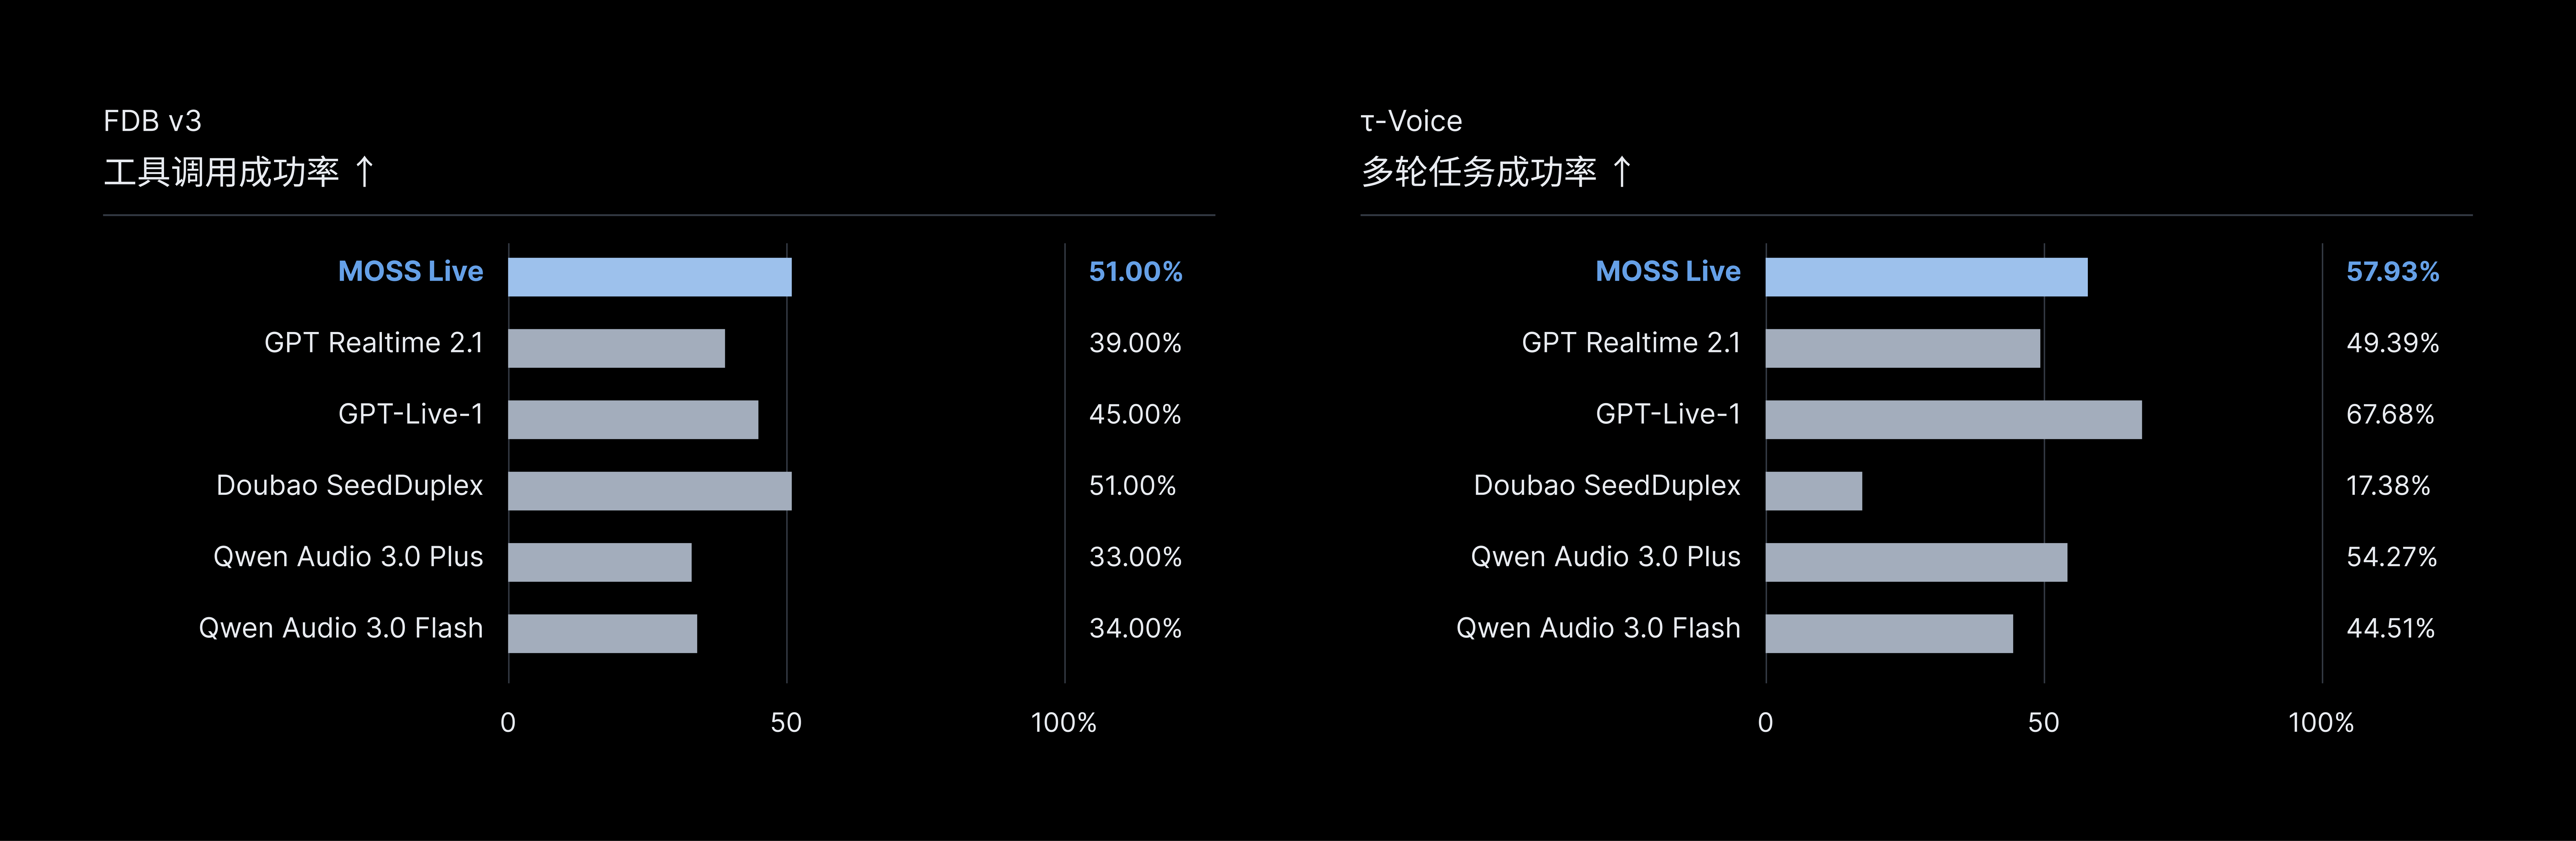
| FDB v3 工具呼叫成功率 ↑ | 51.00% | 45.00% | 51.00% | 39.00% |
| τ-Voice 多輪任務成功率 ↑ | 57.93% | 67.68% | 17.38% | 49.39% |
FDB v3 工具呼叫成功率上,MOSS-Live 達到 51%,高於 GPT-Live-1 的 45%,與豆包並列最高。τ-Voice 多輪任務成功率為 57.93%,較豆包的 17.38% 高出 40.55 個百分點,在原圖六款模型中排名第二;GPT-Live-1 以 67.68% 領先,MOSS-Live 與它相差 9.75 個百分點。
這一區別很關鍵:能否自然地交流,與能否完成多輪任務,需要分別檢驗。MOSS-Live 的全雙工優勢十分明確,而涉及持續規劃和任務完成時,GPT-Live-1 在這項評測中仍然更強。
理解與對話:打斷後接續突出,部分指標仍需提升
| 基準 / 指標 | MOSS-Live | GPT-Live-1 | Doubao SeedDuplex | GPT Realtime 2.1 |
|---|---|---|---|---|
| Big-Bench Audio 總體準確率 ↑ | 88.40% | 80.80% | 90.50% | 90.10% |
| FDB v2 多輪指令遵循 ↑ · /5 | 3.35 | 3.72 | 3.44 | 3.36 |
| FDB v2 實體跟蹤、糾錯與安全 ↑ · /5 | 3.63 | 3.50 | 3.15 | 2.97 |
| FDB v1 打斷後回答質量 ↑ · /5 | 4.88 | 4.67 | 4.51 | 4.57 |
MOSS-Live 的打斷後回答質量為 4.88/5,實體跟蹤、糾錯與安全為 3.63/5,均為原圖參評模型最高。與前面的抗干擾結果結合看,它的強項在於維持交流的連貫性:對話被插入、修正之後,仍能跟蹤資訊並繼續回答。
同時,Big-Bench Audio 準確率為 88.40%,低於豆包的 90.50%;多輪指令遵循為 3.35/5,低於 GPT-Live-1 的 3.72/5 和豆包的 3.44/5。因此,本文的結論聚焦於全雙工互動及對話接續的優勢,不將這些結果擴充套件為所有語音能力的統一排名。
邊交流、邊執行:前後臺如何協同?
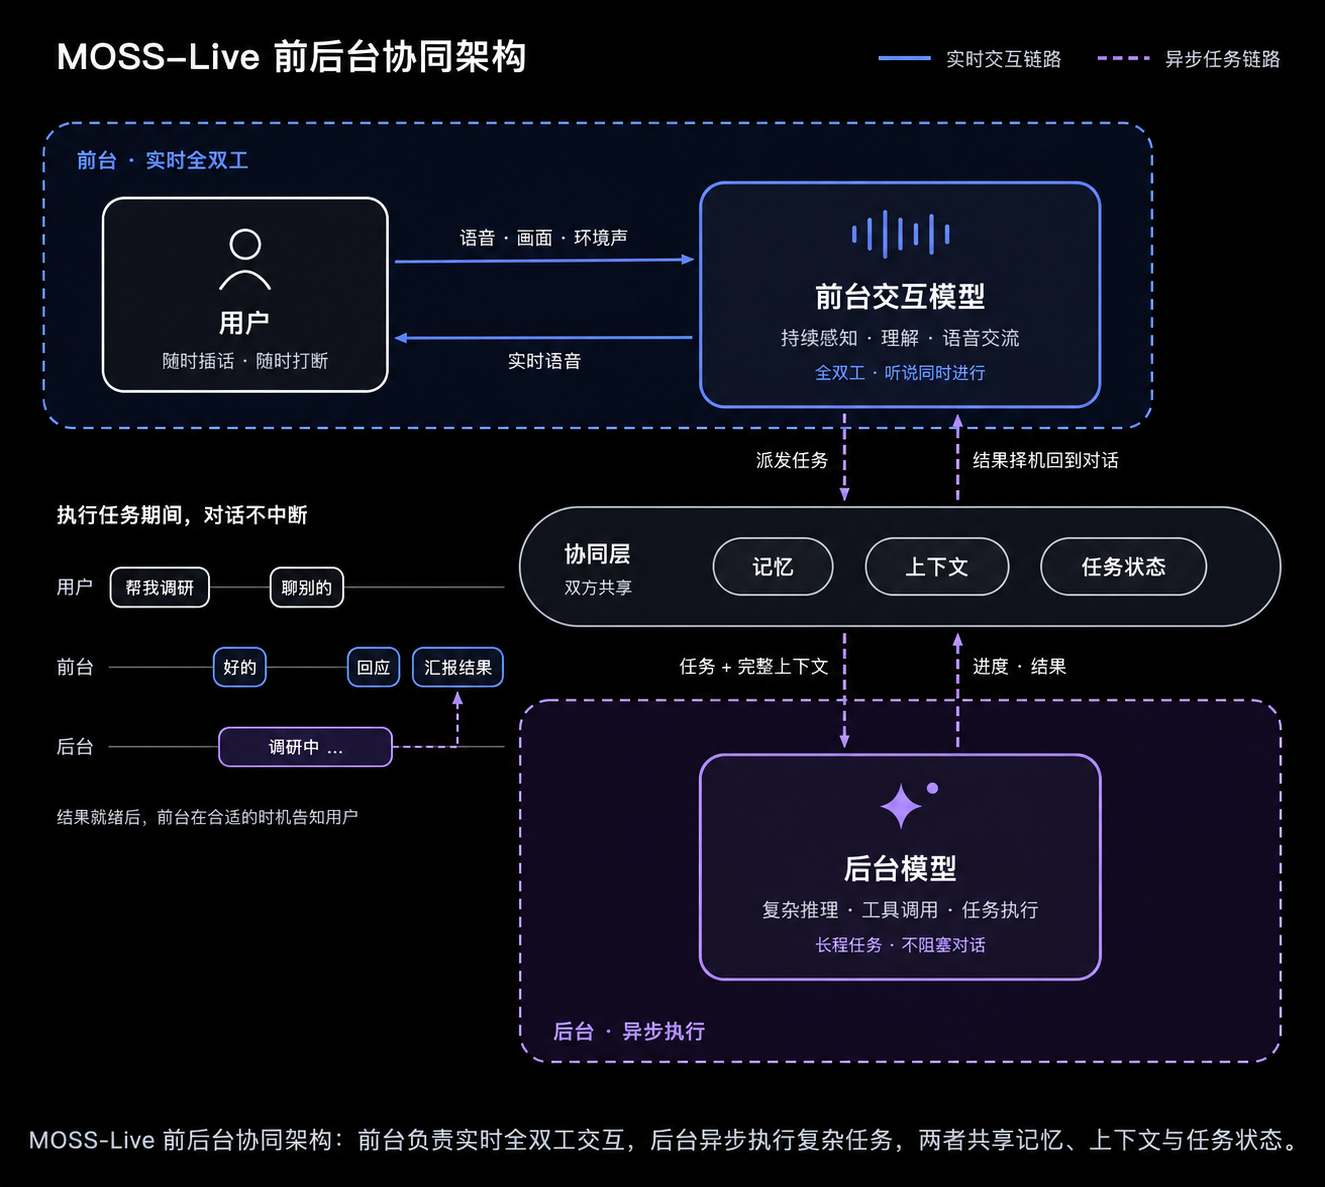
MOSS-Live 支援全雙工語音、語義打斷、即時影片和螢幕共享,以及流式同聲傳譯。它將即時互動與耗時任務分工處理:前臺負責持續感知和交流,後臺承擔複雜推理、工具呼叫與任務執行,協同層在兩者之間共享記憶、上下文及任務狀態。
例如,使用者正在討論旅行計劃時,可以同時交辦酒店查詢,隨後繼續補充行程偏好。查詢在後臺推進,前臺繼續對話,結果就緒後再帶回交流。這種設計讓等待工具結果的時間能夠被用於繼續溝通,也讓新需求有機會進入正在推進的任務。
在連續對話裡觀察這些能力
評測給出可對照的數值,演示則幫助觀察具體的互動過程。以下為官網提供的三個場景;觀看時可以重點留意附和是否造成中斷、新需求如何被接收,以及話題切換後如何返回原任務。
多人會議:討論和查詢同時推進
自駕遊規劃:臨時改需求,再接回原話題
上海旅行:結合即時畫面繼續交流
如何理解這組結果
如果應用最關心的是多人環境裡的誤接話、說話中的干擾和打斷後的接續,MOSS-Live 的評測結果值得重點考察。如果更關心複雜多輪任務完成率,GPT-Live-1 在 τ-Voice 上的領先同樣應該納入判斷;如果側重語音理解準確率,豆包在 Big-Bench Audio 上的優勢也應保留。
本文資料和模型名稱均按 MOSS 官網在 2026 年 11 月 13 日展示的圖表整理,屬於產品方公佈的評測。頁面未展開樣本量、誤差範圍、API 快照及完整評測配置。不同基準的指標不應混合計算總分;尤其 FDB v1.5 與 τ-Voice 的無關語音指標並非互補比例。本文不據此比較延遲、價格或所有場景下的產品體驗。
體驗與來源
來源:OpenMOSS / 復旦NLP / 上海創智 / MOSI · openmoss.ai