OpenAI 訓練並部署啟用分類器作為前沿模型安全監控層
OpenAI 訓練並部署啟用分類器作為前沿模型安全監控層
AI 伴隨問答
針對這篇報導有疑問?可直接點選快捷問題或向 AI 追問背景脈絡與技術細節:
OpenAI:Alignment 研究部落格· Alex Makelov, Xiaojun Xu, Sundaram Ananthanarayanan, Ethan Mcdonald, Tom Dupre la Tour·2026-11-03 04:00· 18 分鐘前精選AI 評分63
Training activation classifiers for safety and alignment
AI 導讀
OpenAI 自 GPT-5.6 起在其最強模型的內部和外部流量上部署啟用分類器(probes),利用模型內部啟用逐 token 即時評分,可在生成中途阻斷違規回覆和工具呼叫並交由推理模型複審。實驗顯示 probes 比更大的文本分類器對測試的越獄攻擊更魯棒,準確率隨模型能力提升,且在後訓練各檢查點間遷移良好,但需為新基礎模型重新訓練,且只能檢測可顯式訓練的已知違規型別。
推薦理由
OpenAI 官方披露啟用分類器的架構、訓練與部署細節,並給出其相對文本分類器在越獄魯棒性上的實驗對比。
2026年11月2日 · Alex Makelov, Xiaojun Xu, Sundaram Ananthanarayanan, Ethan Mcdonald, Tom Dupre la Tour
TL;DR我們將啟用分類器(又稱探針)訓練並部署為額外的一層安全防護,用於我們能力最強的模型。探針是高效的即時監控器,利用模型內部的啟用值來檢測可能違反策略的行為。
- 在生成過程中同步監控。探針會逐個 token 對助手的回覆打分,因此可以在回覆生成過程中即時中斷響應、攔截工具呼叫,並在推理模型進行全面審查時暫停該回復的生成
- 實證表現令人期待。在我們的實驗中,面對測試過的越獄攻擊,探針比基於文本的分類器更穩健;其表現通常隨被監控模型能力的提升而提升,並且能在多個後訓練檢查點之間良好遷移。
探針是對其他安全措施的補充,而非替代。探針通過監督方式訓練,因此只能檢測我們能夠明確訓練它去檢測的內容。由於探針依賴被監控模型的啟用值,新的基礎模型需要重新訓練探針,而且隨著模型權重變化,可能也需要重新訓練。
引言
在 OpenAI,我們訓練模型以安全、對齊的方式行事。儘管這一方向近來取得了進展[OpenAI, 2026b],但仍存在一些情況:對抗性壓力、罕見情形或訓練失敗可能削弱安全性與對齊。為此,我們採用“縱深防禦”策略:在部署模型時附加監控器,用於檢測這類情況並阻止模型進一步行動。具體來說,我們使用執行在使用者提示詞和助手回覆上的文本分類器來實現這一目的。從 GPT-5.6 起[OpenAI, 2026a],我們在這套防護體系中又增加了一層:執行在所有助手回覆上的啟用分類器。
啟用分類器,簡稱探針,是輕量級機器學習模型,利用 LLM 自身的內部啟用值——即它的“神經模式”——來判斷模型活動是否偏離對齊或存在其他不良情況(例如使用者活動帶有有害意圖)。與外部基於文本的分類器相比,探針有多項優勢:它們支援流式決策,可以在模型某一輪對話進行到一半時攔截違反策略的內容;面對越獄攻擊,比規模大得多的文本分類器更穩健;執行效率也顯著更高。此外,探針的準確率通常隨模型能力同步提升:在能力更強的模型啟用值上訓練的探針,本身就是更強的分類器。
探針的一個根本侷限在於依賴有標註的訓練資料;我們只能用它檢測已知且可測量的不良活動型別。探針還有一些執行層面的限制,源於它與被監控模型前向傳播的緊密耦合。在一個模型啟用值上訓練的探針,與權重初始化不同的另一個模型的啟用值不相容。尤其是,每出現一個新的預訓練基礎模型,探針都需要重新訓練。即便在同一基礎模型系列內,隨著模型權重偏離訓練探針時所用的檢查點,探針效能也可能下降,因此需要定期重新訓練[見遷移部分]。
我們已在能力最強的模型的內部和外部流量上部署了探針。它是我們內部失準監控系統的一個組成部分,與基於模型的審查、自動化調查和人工響應並列。這篇博文介紹我們的方法以及一些重要發現。下圖資料來自各項內部實驗,未必能代表實際部署的分類器。
方法
架構
探針以殘差流啟用向量為輸入(通常取自模型中間某一層),輸出對應二分類任務的 logits(例如預測某段補全是否違反給定策略)。
我們的架構基於 Attention probes [Kantamneni et al. (2025)],採用 MLP + QV-attention 結構,並加入指數移動平均。1 與滾動均值([McKenzie et al. (2026)]、[Kramar et al., 2026])相比,指數移動平均把探針的流式狀態記憶體從 O(window_size * num_heads) 降到 O(num_heads)。實踐中我們發現,兩種方法的預測能力基本沒有差別。我們還額外加入了一個可學習的 pre-MLP 偏置,其初始值取自訓練啟用均值(負值)的估計;我們發現這能讓訓練中的最佳化更穩定。在許多領域,我們訓練多輸出探針,在共享探針大部分權重的同時提高分類的粒度。這有助於某些訓練資料有限的輸出類別更好地泛化。
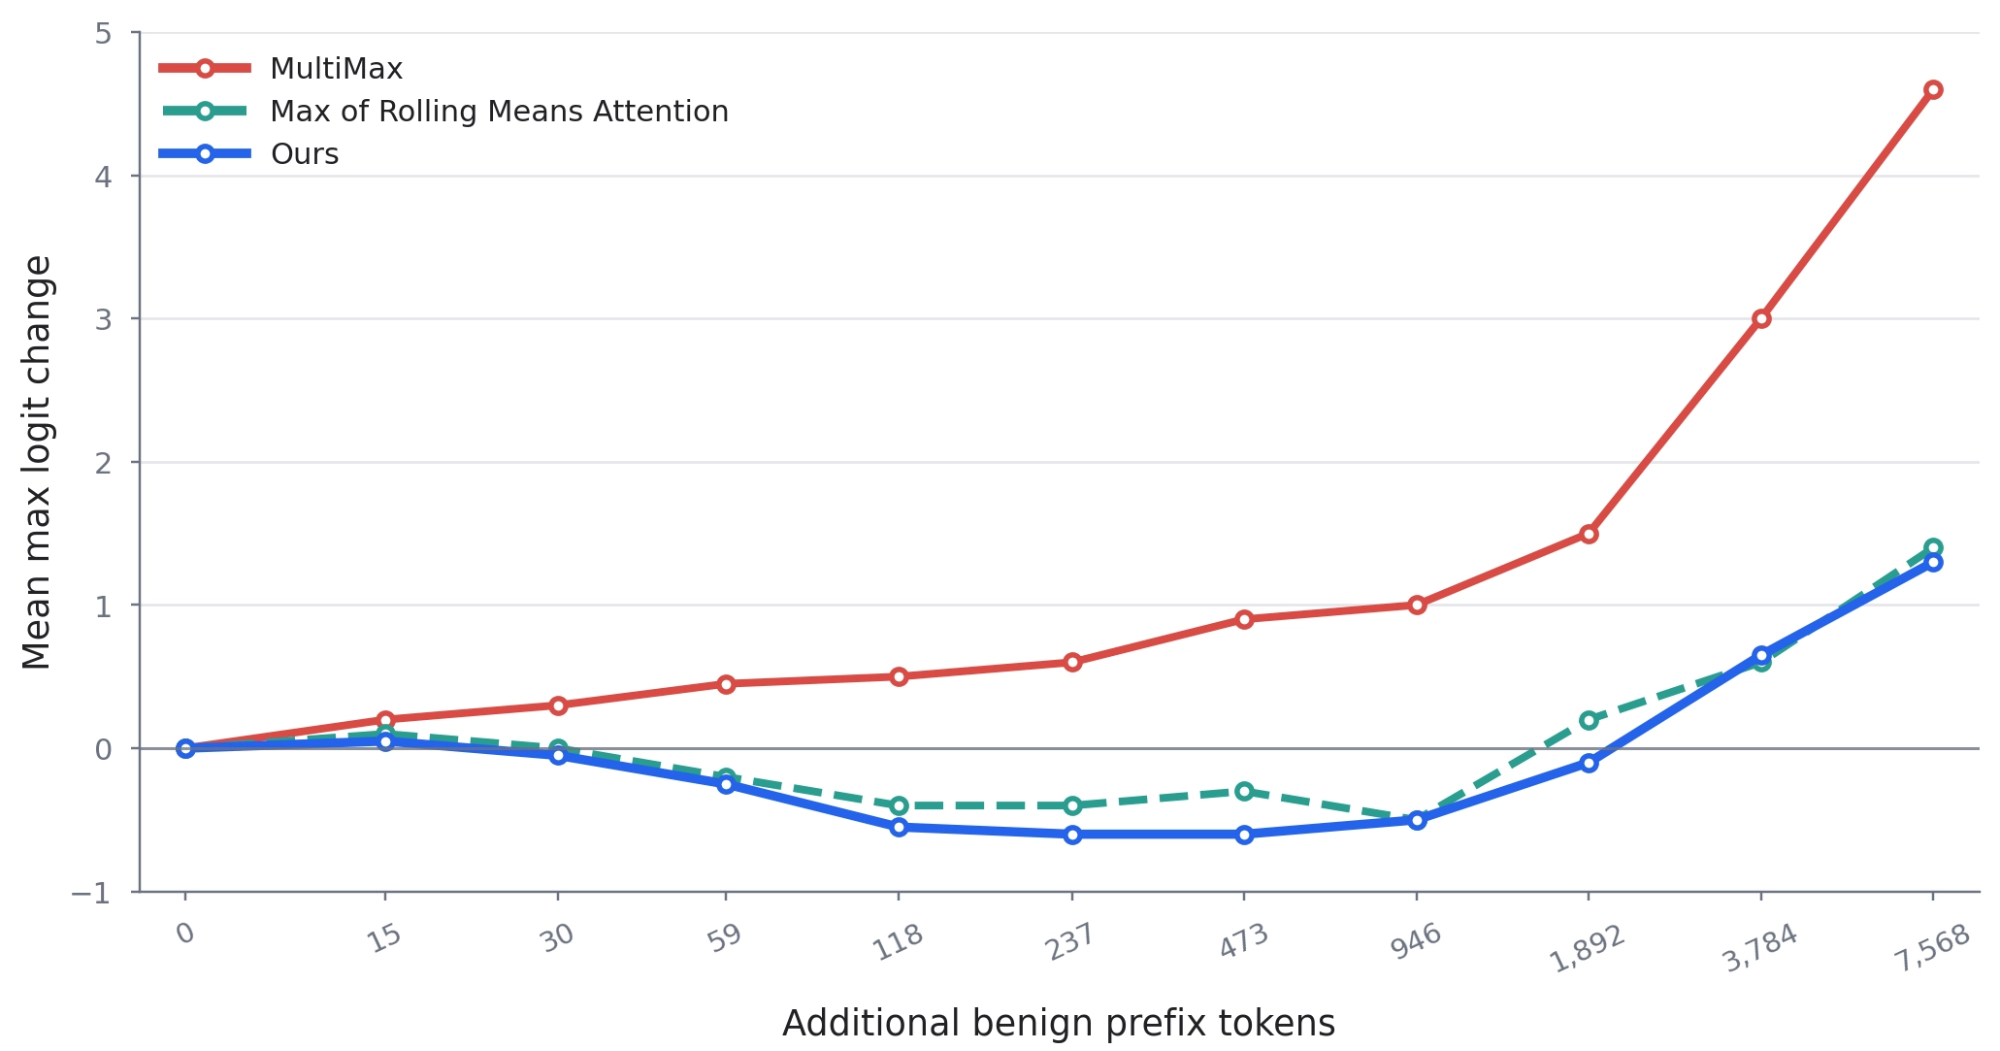
在選擇架構的過程中,我們做了魯棒性實驗,檢驗探針預測對助手訊息中違規字尾之前所放置的良性 token 序列是否保持不變。我們觀察到,MultiMax 探針架構 [Kramar et al., 2026] 受良性字首的影響明顯大於 Max of Rolling Means Attention 架構 [Kramar et al., 2026],而後者與我們的指數衰減注意力架構非常相似(圖 1)。
滾動 softmax 目標
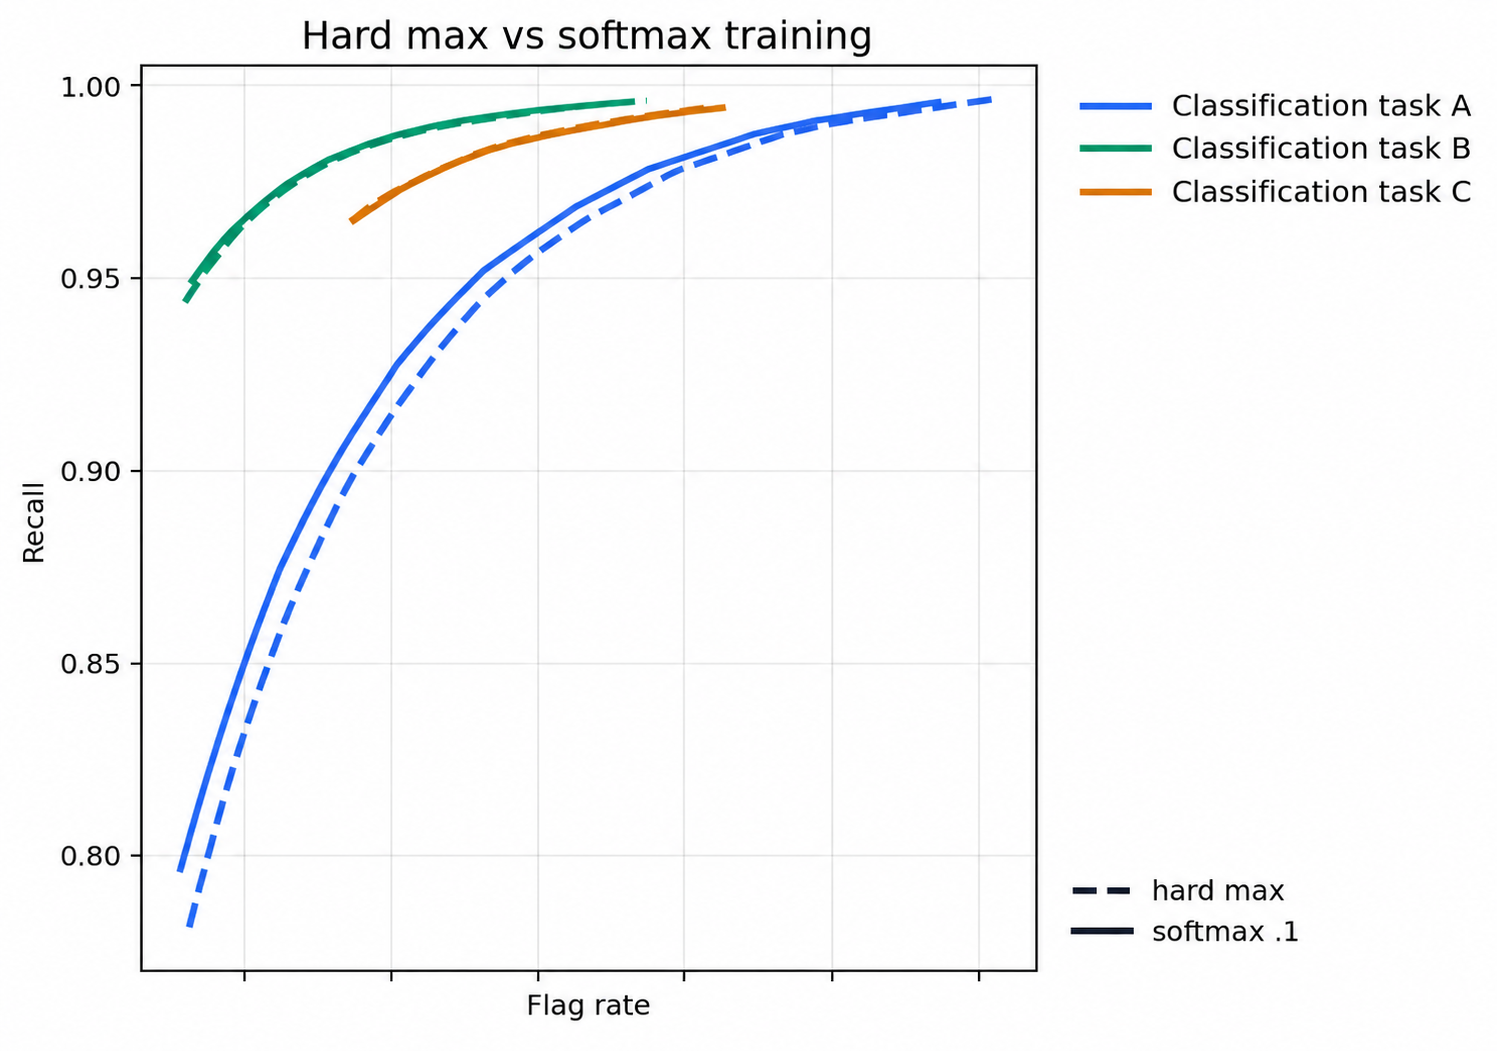
與 [Kramar et al., 2026] 和 [Cunningham et al., 2026] 類似,我們訓練探針時每條訊息只用一個標籤。因此,架構和訓練目標必須把學習集中在相關的 token 位置上。推理時,隨著助手回覆被逐 token 取樣,探針對每個訊息字首計算一個分數,一旦該分數越過閾值,我們就將該訊息標記出來。訓練時,我們用 softmax 運算聚合這些分數,得到單個訊息級分數並對其施加監督。這與 Kramar et al. (2026) 的聚合方法不同,後者對各字首分數取硬最大值。我們推測,softmax 聚合能更好地把監督分配到各個字首上。實驗表明,softmax 聚合能小幅改善召回率/標記率的帕累托前沿(圖 2)。
訓練、模型選擇與評估
我們採用與 [Anderson et al., 2026] 類似的縮放方法來收集啟用值,然後在同一批收集到的啟用值上訓練大量探針。通常我們最多使用 100 萬條訓練訊息,並且在這一規模及以下都能看到分類效果的提升。資料來自合成對話與去標識化對話的混合。訓練標籤由我們能力最強的推理模型作為 LLM 評判員給出。
正如 [Kramar et al., 2026] 中所觀察到的,探針權重的隨機初始化對探針預測效能有很大且可泛化的影響。因此,對每組超引數配置,我們通常至少訓練 32 個隨機初始化。我們一般會掃描若干組配置,在驗證集上選出表現最好的隨機種子,再在留出的評估集上檢查最終效能。我們發現,需要掃描的關鍵超引數是學習率、啟用來源層和架構容量。
訓練探針時,我們使用 AdamW 最佳化器,訓練幾個(<5)epoch。由於探針權重相比其需要處理的訓練啟用值很小,訓練主要受頻寬限制。因此,我們在訓練時對探針權重做向量化並融合,從而在同一加速器上聯合訓練數十個探針,耗時幾乎與訓練單個探針相當。這讓我們可以輕鬆擴充套件每組配置的隨機種子數量。2
評估方面,我們在一個精心標註的小資料集上測量召回率,並另在一個能代表探針預期部署場景的大數據集上評估升級率(即觸發探針的相關訊息佔比)。在不同探針閾值下,由此得到一條召回率-升級率曲線,它是我們決定探針部署與配置的主要依據。為評估探針對越獄的魯棒性,我們還結合使用自動化與人工紅隊測試。
部署
探針以流式方式直接執行在推理引擎上(僅為 token 池化保留最小緩衝區),每取樣一個 token 返回一個 logit。因此,探針的系統可靠性與模型本身幾乎相同;特別是與外部文本分類器相比,探針更容易做到失效即關閉(fail-closed)。
系統會將分類器 logit 與每個取樣 token 一起記錄。只要某個 logit 超過閾值,我們就停止向用戶流式輸出補全內容,並將該訊息升級交給推理模型做最終判斷。工具呼叫也會被阻止,直到該呼叫被標記為安全。
探針的一些經驗性質
模型檢查點之間的遷移
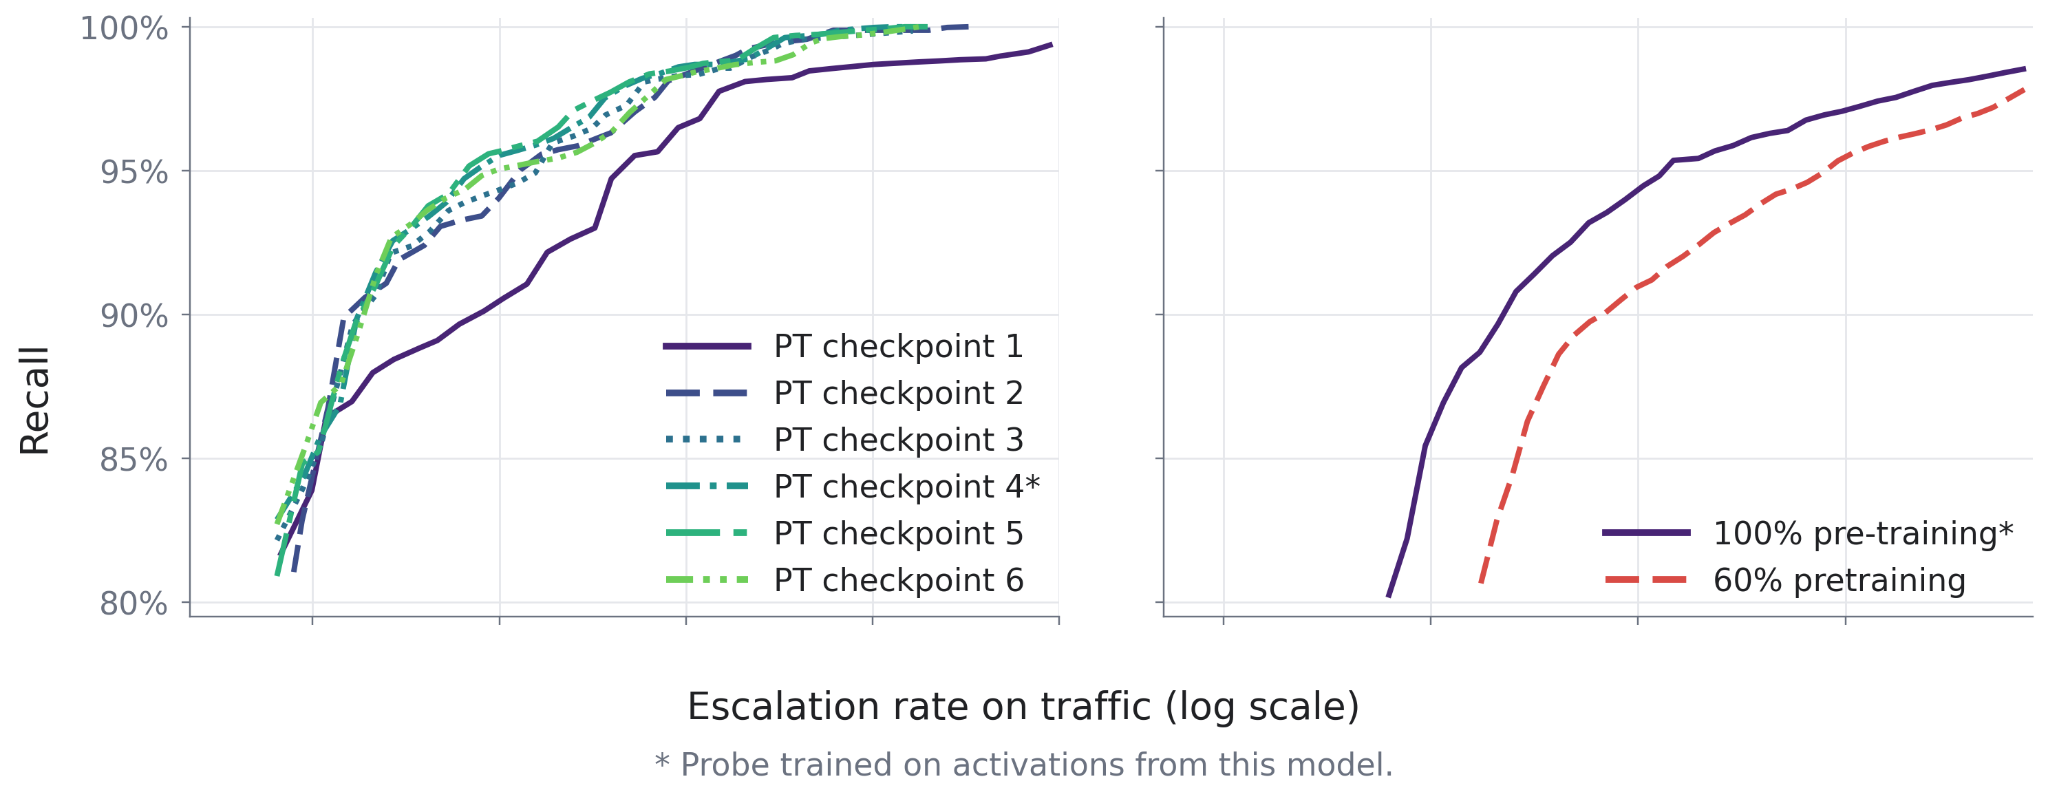
在一個模型的啟用值上訓練的探針,應用到另一個模型的啟用值上時,行為通常會有所不同。不過,對於足夠相似的模型,我們預計分類器質量下降很小。為了量化可接受的相似程度,我們評估了探針在訓練後不同階段之間,以及不同預訓練量之間的遷移情況(圖 3)。我們觀察到,在許多訓練後階段之間遷移效果很好,而在預訓練檢查點之間遷移則較為有限。
對越獄的魯棒性
已有研究表明,基於啟用的監控器對某些越獄攻擊具有魯棒性,並且能與基於文本的分類器互補 [Patel and Wang, 2024],[Cunningham et al., 2026]。探針還可能檢測出通過編碼表達的內容——被監控的模型能理解這些編碼,而外部分類器卻難以解讀 [Sel et al., 2026]。因此,這很可能使探針對某些類別的越獄具備魯棒性。
對於並非直接針對探針最佳化的越獄,魯棒性尤其高。不過,現實世界中的攻擊可以針對我們安全棧發出的訊號進行調整。因此,我們對自身的安全防護措施進行了大量紅隊測試 [OpenAI, 2026a]。在這些測試中,我們發現探針總體上比基於內容的分類器對越獄更魯棒。
效能隨模型能力擴充套件
對於固定的分類任務,文本分類器始終看到相同的輸入,因此表現也相同。但探針的輸入是被監控模型在固定任務實例上的啟用,而這些啟用在不同模型之間並不相同。包括 [Nordby et al., 2026] 在內的已有研究表明,探針準確率可以隨模型能力提升而提高。我們也觀察到了這一趨勢,並且在我們前沿模型上,探針效能持續提升。
結論
探針已成為 OpenAI 安全與對齊策略中不可或缺的一部分。它們是我們更廣泛的檢測和調查前沿模型失配工作中的一個組成部分。我們正在積極訓練和部署更好的探針,並擴大其覆蓋的策略範圍。我們計劃繼續發展白盒分類器的科學,著眼於提升其泛化能力和魯棒性。
致謝
本報告主要關注與探針架構和訓練相關的技術細節。在前沿模型上部署探針需要許多團隊的廣泛協作。我們感謝 OpenAI 安全系統團隊和 Preparedness 團隊中為這項工作提供幫助的許多人。我們還要感謝 Isak Czeresnia Etinger、Paul Rosu、Ian Kivlichan、Bowen Baker、Jakub Pachocki、Kai Chen 和 Gaby Raila 對本文提出的深思熟慮的意見。
腳註
- 我們還試驗了線性探針(包括對來自多層的啟用進行拼接)[Cunningham et al., 2026]、MultiMax 探針 [Kramar et al., 2026] 和協方差探針 [Dooms et al., 2026],但都沒有提升預測效能。全注意力探針效能相近,但缺少 QV 注意力探針那種低緩衝流式實現。僅使用單層啟用的探針也因推理基礎設施更簡單而更受青睞。↩
- 請注意,以這種方式耦合探針意味著它們以相同順序看到資料,這可能會減少對可能探針空間的有益探索。不過,一項受控實驗表明,探針效能的離散程度絕大多數源於初始化隨機性(約 85% 的方差份額)。↩
來源:OpenAI:Alignment 研究部落格 · alignment.openai.com