
PyTorch 記憶體規劃:dp_knapsack_sliding_hirschberg 使峰值記憶體下降 20 倍
0/1 Knapsack Problem in PyTorch
dp_knapsack_sliding_hirschberg 是 PyTorch 新增的 0/1 背包演算法,透過滑動視窗與 Hirschberg 技巧,將記憶體峰值降低 20 倍並提升 37% 執行速度。
本文說明如何利用滑動視窗與 Hirschberg 技巧,將 PyTorch 記憶體峰值降低 20 倍,對大規模模型訓練有實際效益。
TL;DR: 如果你使用預設的 torch._functorch.config.activation_memory_budget_solver=dp,你可以改成 dp_knapsack_sliding_hirschberg,並在記憶體規劃時將峰值 RAM 使用量降低 20 倍。
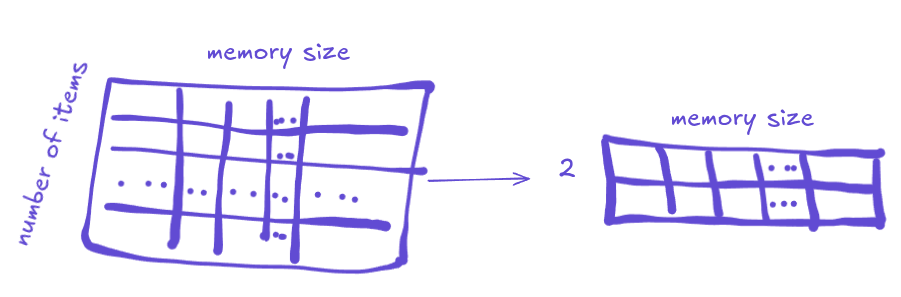
什麼?
當 PyTorch 為你的機器學習模型構建計算圖時,它會嘗試許多不同的方法以提升速度與記憶體效率。 一種技巧是將前向與反向計算圖結合,並選擇哪些操作應該被儲存(存入記憶體並重複使用),哪些操作應該重新計算。 每個操作執行需要一定時間,若被儲存則佔用一定記憶體,而我們只能使用有限的記憶體。
0/1 背包問題
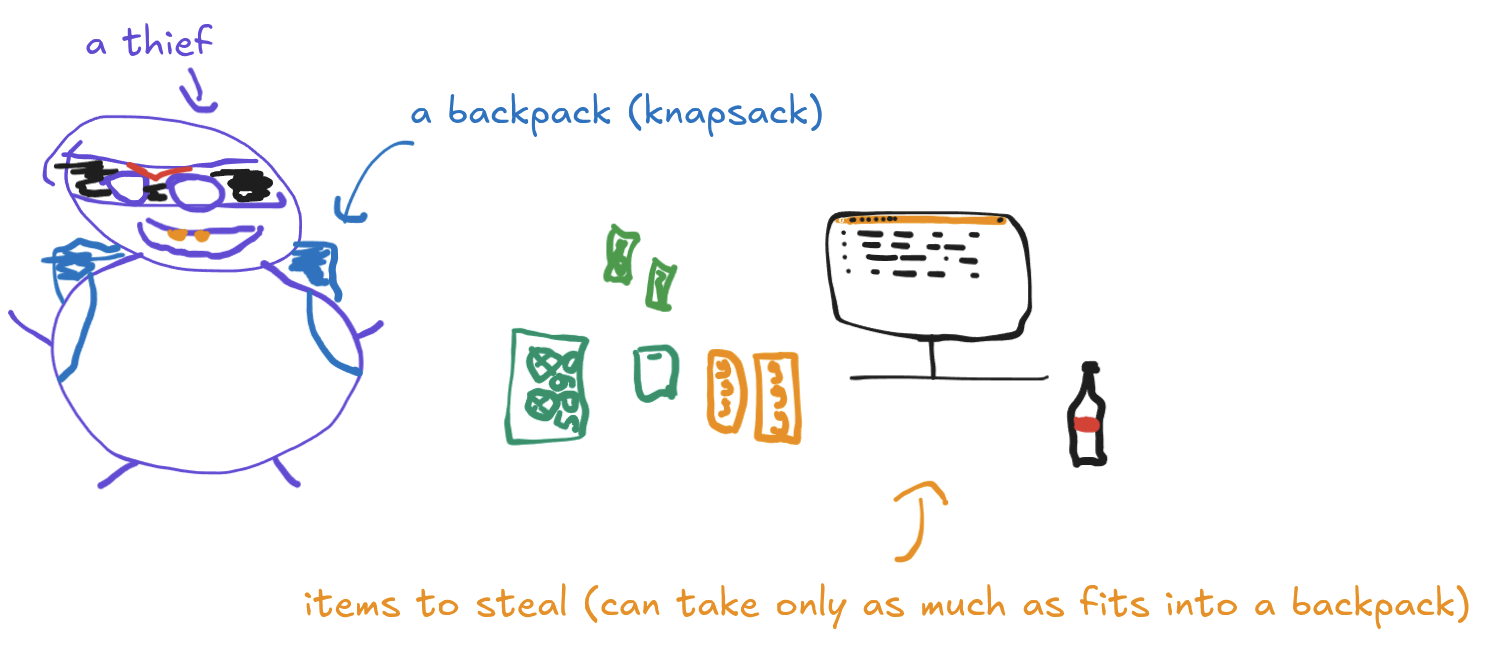
想像你是一名盜賊,剛剛闖入一個內部充滿貴重物品的地方。你有一個可容納最多 10 公斤的背包。你想最大化偷走物品的價值。理想情況下,你會把所有東西都帶走。但如果你裝進 10 公斤以上,背包會破裂,你將一無所獲。另一種做法是使用一些啟發式方法挑選物品(例如只拿小物件或只拿綠色物件),但這樣你的解可能不是最優——你會偷到一些價值,但可能比最優選擇少。為了幫助你,出現了 0/1 背包求解器。有不同的演算法能在給定容量(背包可承載的最大重量)和一份物品清單(每件物品都有價值和成本(重量))下計算最優物品選擇。在 PyTorch 中,我們實際上做的是:在一個 RAM 預算(背包容量)內,選擇哪些操作(物品)應該被儲存到記憶體,以最大化執行時的時間節省(價值)。
dp_knapsack
目前,PyTorch 中背包求解器的預設實作是 dp_knapsack,它是解 0/1 背包的動態規劃方法。當你理解之後,這個演算法其實相當簡單。若你之前有動態規劃的經驗,會大有幫助(我沒有)。請參考來自維基百科的這個漂亮 GIF:
 By RDSEED - 原創作品,
CC
BY-SA 4.0, Link
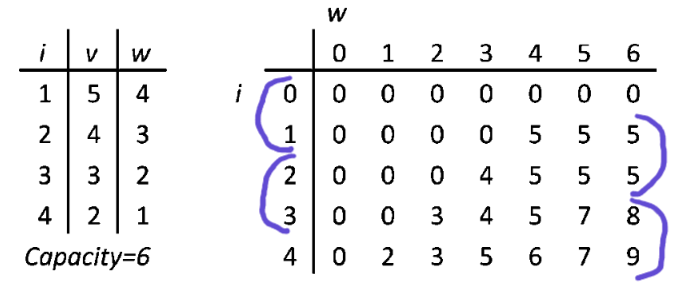
左側有一個 4 個專案的列表。i 是索引,v 是價值,w 是重量。單位不重要。容量為 6。這就是為什麼右側有 6 列(每列代表總容量的一部分)和 4 行(每項一行)。其實還有 7 列和 5 行,因為用零填充,但這只是為了計算方便(每行每列都有父節點,索引運算更簡單)。你其實可以不加填充,但我嘗試後還是回退到填充,因為索引運算有點麻煩。右側的表格稱為 DP 表格,計算就發生在那裡。
建立 DP 表格
DP 0/1 背包演算法如下:取得一個專案。在 DP 表格中,逐行、逐列,將你的專案價值與目前 DP 表格格子(行、列;目前列索引即為你的背包最大重量(容量))的值做比較。若你的專案重量大於目前列索引,則移至下一列。若專案重量等於列索引且專案價值高於目前格子,則以專案價值替換格子。若專案重量小於列索引且能放進剩餘容量,則將其加入格子值(剩餘容量為目前容量減去已選專案容量)。重複此過程直到遍歷完所有專案。此時,你知道在重量預算內可獲得的最大價值。若我們的目標只是測量最大可能價值,則此時即可停止。不幸的是,我們想知道更多。
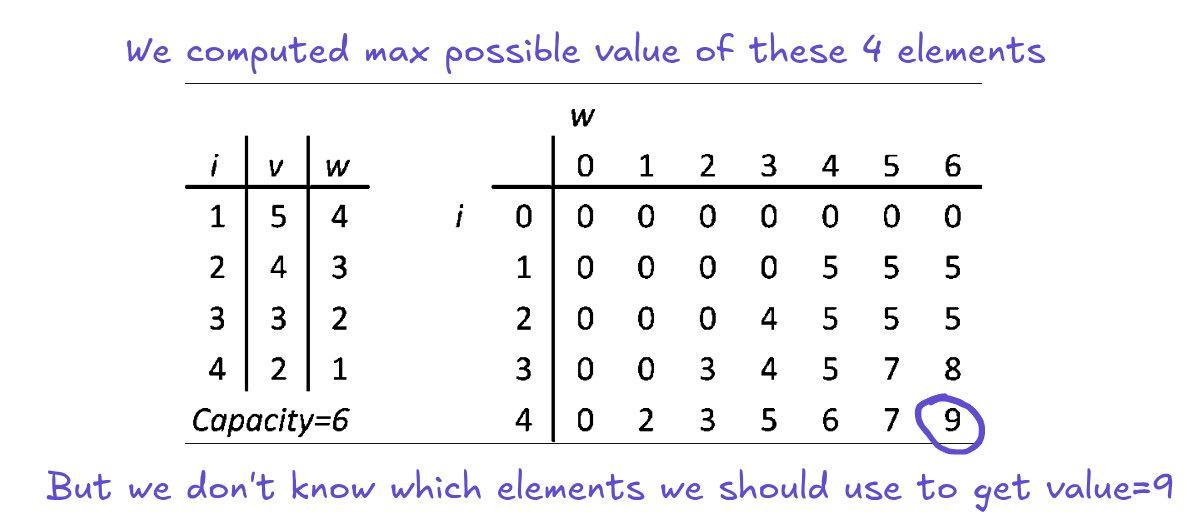
回溯
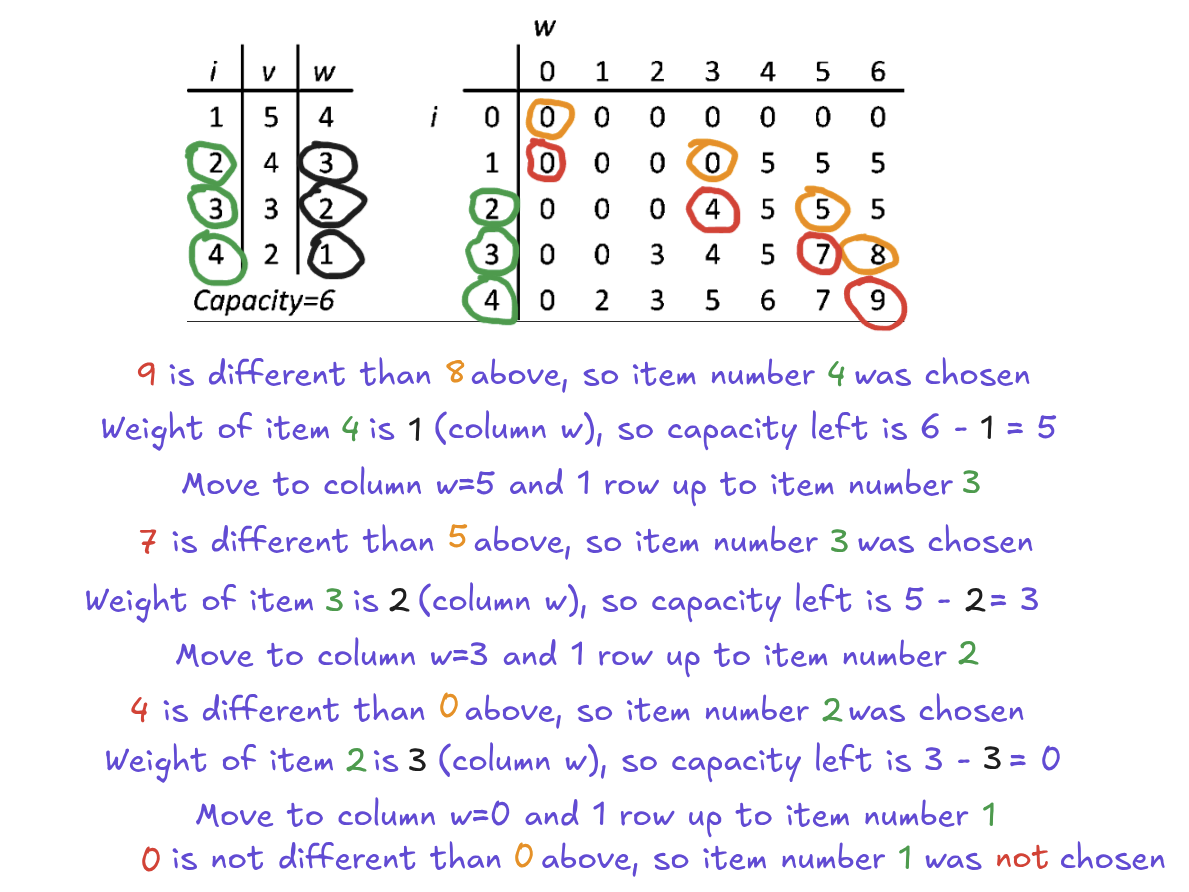
我們需要知道哪些專案應該拿來得到這個最大可能價值。因此,在 PyTorch 的情況下,哪些操作應該儲存到記憶體,哪些操作應該重新計算。為了找出哪些專案對最大價值有貢獻(換句話說,哪些專案在構建 DP 表格時被選中),我們需要從後往前走 DP 表格。我們從最後一行最後一列往上走。將一格與上一行同一列的格子做比較。若兩者不同,則目前專案貢獻於最大價值——因為每一行對應一個專案。若相同,則此專案不會被存到記憶體,會變成可重新計算。現在,我們沿著 DP 表格往上走。若該專案被選中,我們向上移動一行,並將目前格子的位置往左移動等於所選專案的重量。若該專案未被選中,我們向上移動一行,並在同一位置開始。重複此過程直到到達 DP 表格頂端。
最佳化
此解算器正確工作。它提供精確解,且大多數情況下你不需要更好的。更好的意思是 1. 更快 2. 更省記憶體。因為再看一次演算法與上方 GIF。它有幾個問題。要得到結果,我們分配一個完整的 2D 表格,形狀為(專案數量,最大重量),這並不理想。Horace He (Chillee) 原先構建了 PyTorch 大部分(所有?)記憶體規劃,留下備註在 DP 背包解算器程式碼中:
# TODO(chilli): I think if needed, this memory can be optimized with sliding
# window trick + Hirschberg trick:
# https://codeforces.com/blog/entry/47247?#comment-316200
他提出了兩項最佳化。
滑動視窗
視窗技巧的意思是,與其建立 DP 表格,我們不如滑動 在表格上滑動,只使用上一行和當前行。當移動到下一行時,下一行成為新的 當前行,舊的當前行變成上一行。這一改進單獨就足夠,如果我們只是想計算專案在 我們列表中,在給定容量內的最大值。但仍需知道哪些專案貢獻了這個最大值。這就是 Horace 建議同時使用滑動視窗和 Hirschberg 技巧的原因。
Hirschberg 技巧
這是一種分而治之的策略,類似於快速排序,因為你將問題拆分成更小的子問題並解決,並持續拆分直到解決整個問題。Hirschberg 技巧對我們的主要好處是它消除了回溯。
從實作角度來看,我在這裡做了一種遞迴,但不會把新框架塞進堆疊。我有一個 Python list 作為明確的堆疊(後進先出)。這個 list 儲存一個專案索引範圍和目前可用容量。我們以所有專案和全部容量開始。然後演算法流程如下:首先,我們從堆疊中彈出一個專案。如果它是一個單一專案(專案索引範圍結束-開始 = 1),檢查該專案的重量是否符合可用容量。若符合,將其加入已儲存專案;若不符合,加入可重新計算專案。這部分在我看來是 Hirschberg 演算法對我們最大的優勢——因為你現在可以看到,我們不需要回溯,因為我們在演算法內部建立已儲存與可重新計算清單。無需在之後再構建,與原始 0/1 DP 背包演算法不同。若專案範圍大於 1,將專案拆成兩部分,對每個部分計算 DP 表。我們不想構建完整的 DP 表,所以這裡使用滑動視窗技巧,重複使用目前與上一行 DP 來計算最終 DP 行。
一旦我們得到左側與右側的 DP 行,將它們相加。找出最高值的位置。這將成為我們記憶體的新分割點。現在我們把記憶體分成兩段,使用這個新計算出的位置,並再次執行演算法,使用已分割的記憶體與專案。重複直到完成。順便說一句,可能會發生其中一個拆分部分為空的情況。當最佳拆分是第一個或最後一個專案時會發生這種情況。這完全合理,我們只需跳過這個堆疊框架並繼續即可。
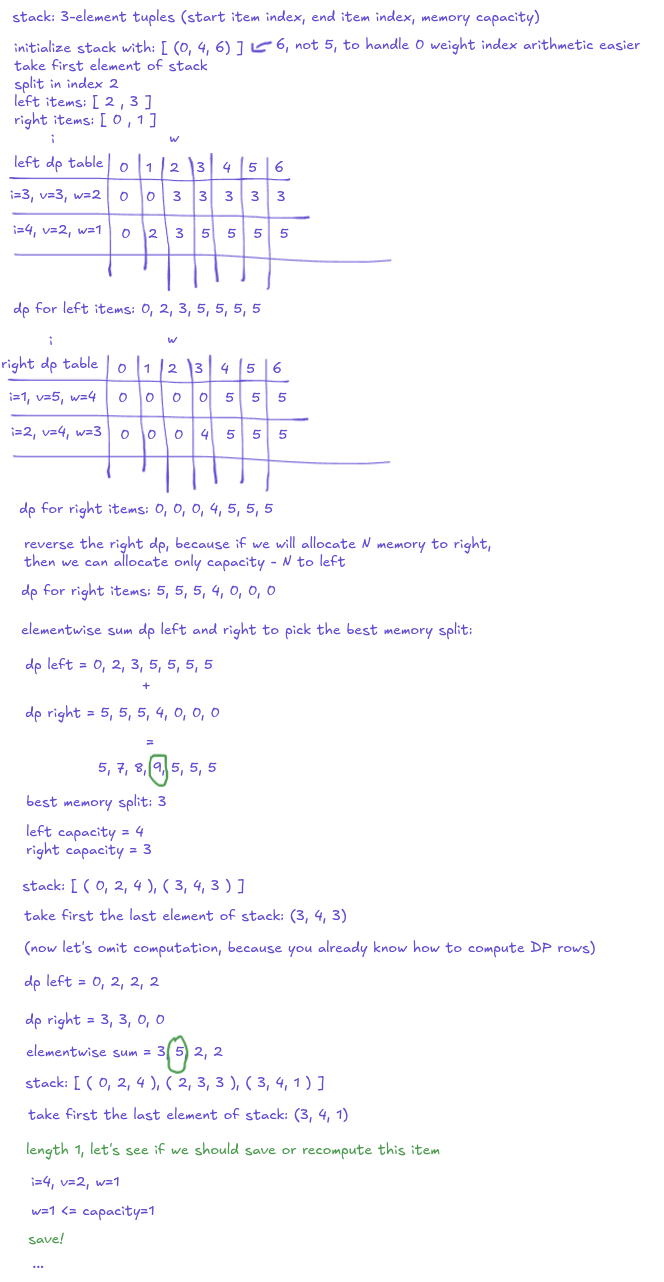 這裡 是一個很好的說明,配有逐步圖示的 Hirschberg 演算法,作者為 KokiYmgch 在 CodeForces 上
那麼,dp_knapsack_sliding_hirschberg 現在是主要解法嗎?
不。看——將這兩個最佳化結合起來,我們可以將 DP 表尺寸從 shape=(專案數, 最大重量) 降為 shape=(2, 最大重量),實際上把峰值記憶體降低了 20 倍——在我的 64GB RAM 機器上,dp_knapsack 在 100 個專案的問題上會崩潰,而 dp_knapsack_sliding_hirschberg 能在相同 RAM 範圍內處理 2000 個專案的問題。我們也獲得了一些執行時間加速,大約 37%,但我並未非常嚴謹地測量。話雖如此——如果你不介意使用 SciPy,那麼你可能應該改用 ilp_knapsack。它比任何現有的 PyTorch DP 背包實作都快得多。它比貪心演算法稍慢,但仍非常快,且與貪心演算法不同,與兩個 DP 解法相似,它提供精確解。
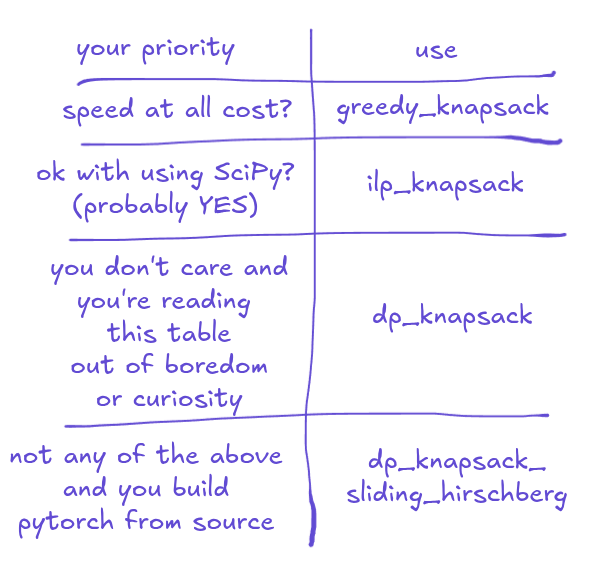
如何為你挑選合適的解法
如果你更在意速度而非正確性,請使用 greedy_knapsack。
否則,如果你願意將 SciPy 拉進專案,請使用 ilp_knapsack。
否則,如果你從套件管理器安裝 PyTorch,則不需要任何操作——PyTorch 會使用 dp_knapsack,這是預設解法,你不必做任何事。
否則,使用 dp_knapsack_sliding_hirschberg。
如何使用 dp_knapsack_sliding_hirschberg
import torch
import torch._functorch.config as fconfig
fconfig.activation_memory_budget_solver = fconfig.dp_knapsack_sliding_hirschberg
若在使用 dp_knapsack_sliding_hirschberg 時發現任何錯誤,請註冊問題並標註我@jmaczan,我會盡快解決。
感謝 Edward Yang 的程式碼審查與合併, 感謝您閱讀。